“推理算力已成AI主流”“AI正在重新定义计算的每一个层次”“智能体时代(Agentic AI)将重构算力格局”。
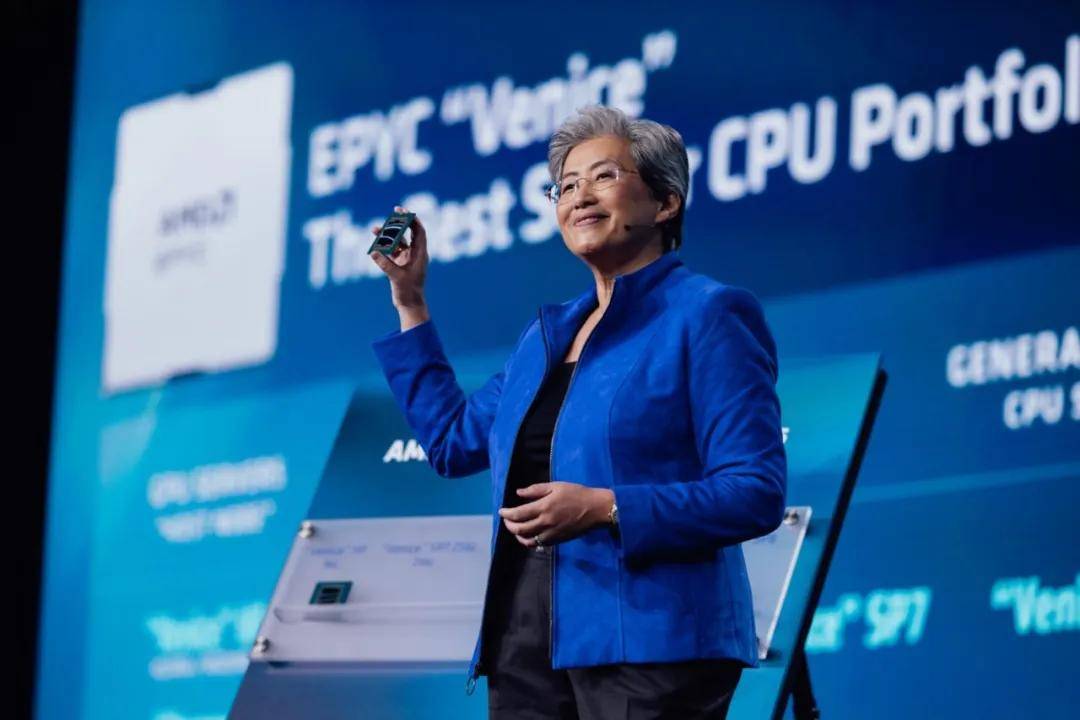
AMD Advancing AI 2026大会上,AMD董事会主席及首席执行官苏姿丰博士(Dr. Lisa Su)站在舞台中央,向全球开发者、合作伙伴与投资者描绘了一幅从芯片到机架、从云端到边缘、从训练到推理的全栈AI计算蓝图。
苏姿丰博士的宣讲远不止于技术趋势的描述,还揭示了GPU产业竞争范式正发生根本性转移!过去十年,AI芯片的叙事围绕着“谁拥有更强的单卡算力”展开。而今天,当推理工作负载在AI总支出中的占比不断攀升,当全球Token消耗量呈指数级增长——这意味着,市场对于GPU的需求早已从“更强的单卡性能”转向“更高效、更具扩展性且能够支撑大规模AI部署的整体算力平台”。
在这一转折点上,AMD的角色也在发生深刻变化。
十余年前,AMD在苏姿丰博士的带领下,确立了“Zen架构复兴”与“数据中心多元化”的双轨战略。此后十年间,AMD的股价一路攀升,至2026年6月触及584.72美元的历史峰值,市值一度达到约9469亿美元,曾一度逼近英特尔同期市值的2倍,并跻身全球市值第17位。
如果说这场超过290倍的资本增长,见证了AMD的第一次蜕变,那么站在AI智能体时代加速到来的关键节点,AMD正在开启一场更具战略意义的第二次蜕变。
这一次,AMD不再只是追逐算力性能的提升,而是以系统级创新为“帆”,以开放生态为“舵”,从CPU、GPU到网络、软件,再到机架级系统,构建覆盖全栈的AI基础设施能力。本届大会亮相的Instinct MI455X、Helios机架系统、第六代EPYC“Venice”处理器、ROCm.AI智能开发平台以及Kria AI机器人解决方案,正成为AMD迈向“AI基础设施提供者”的关键支点。
从一颗芯片,到一套系统,再到一个开放的AI生态,AMD正在完成从产品竞争到平台竞争的跨越。属于AMD的第二次蜕变,已经启程。
AMD洞察算力新范式
AI竞争不再只是拼GPU性能
在Advancing AI 2026大会上,苏姿丰说了一句被产业界广泛引用的话:“前沿AI已经无法依靠单颗芯片或单台服务器满足需求,整个机架必须作为一个系统来设计。”这句话道出了当前GPU产业竞争范式转移的核心驱动力。
首先,AI算力需求的爆炸式增长已使单卡性能的提升速度难以跟上工作负载的膨胀。根据Epoch AI的数据,自2020年以来,前沿AI模型训练所需的FLOPS每年增长约5倍。与此同时,AI推理的Token月消耗量在过去两年间增长了158倍。这种指数级增长意味着,即便单颗GPU的峰值算力每代提升数倍,也无法独立满足超大规模AI部署的需求。
其次,AI工作负载的结构正在发生根本性变化。行业统计数据显示,AI推理在总AI支出中的占比已从2024年的40%上升至2025年的50%,并将在2026年达到60%。推理与训练对系统架构的要求截然不同,训练追求极致的并行计算能力与显存容量,而推理则对延迟、吞吐量、成本效率和系统扩展性提出了更为复杂的综合要求。
第三,电力与散热已成为数据中心扩容的硬约束。当前超大规模数据中心的机架功率预算普遍集中在100kW级别,而单颗旗舰GPU的功耗已接近1kW级。在这种约束下,单纯堆砌单卡性能不仅无法提升有效算力产出,反而可能因散热和供电瓶颈导致整体效率下降。因此,每瓦可承载的智能体数量、每美元可生成的Token数等系统级能效指标,正在取代单卡峰值TFLOPS成为行业客户决策的核心依据。
这些趋势共同指向一个结论:GPU产业的竞争已从“单卡跑分”时代进入“系统级优化”时代。客户购买的不再是一颗芯片,而是一个包含计算、内存、网络、散热、软件栈和运维工具的完整算力平台。这正是AMD在Advancing AI 2026上力推“机架即系统”设计理念的根本原因。
AMD亮出“芯+架”组合拳
AI算力竞争从单卡走向整机架
AMD Advancing AI 2026大会的核心硬件发布,完整呈现了其从芯片到机架的系统化设计能力。
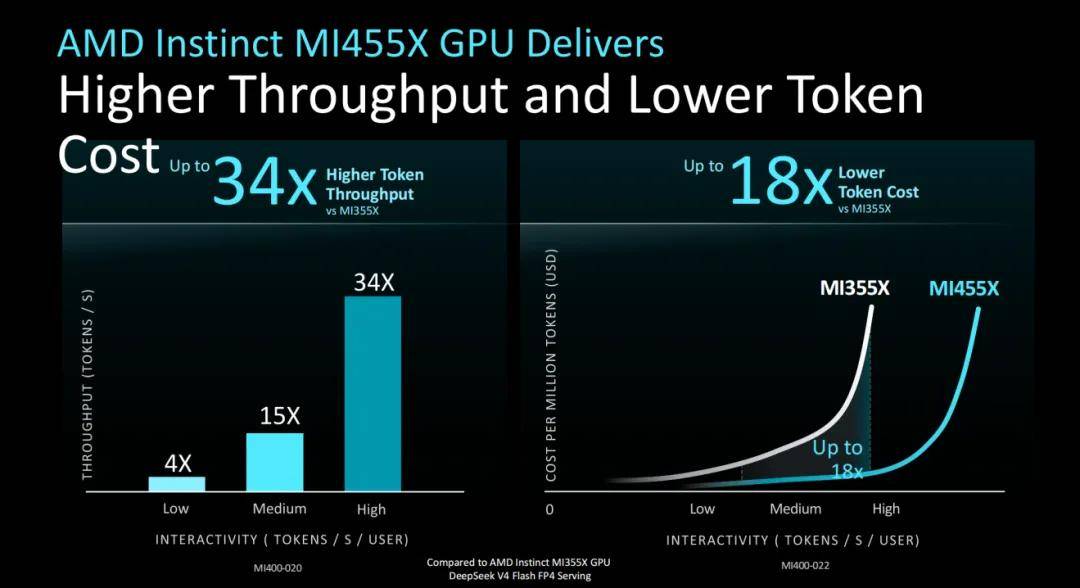
Instinct MI455X是AMD基于CDNA 5架构推出的旗舰数据中心GPU,MI455X的Token吞吐量最高可达上一代MI355X的34倍,单位Token成本最高降至上一代的约1/18。这些数据表明,AMD在单卡层面的性能追赶已取得实质性突破。
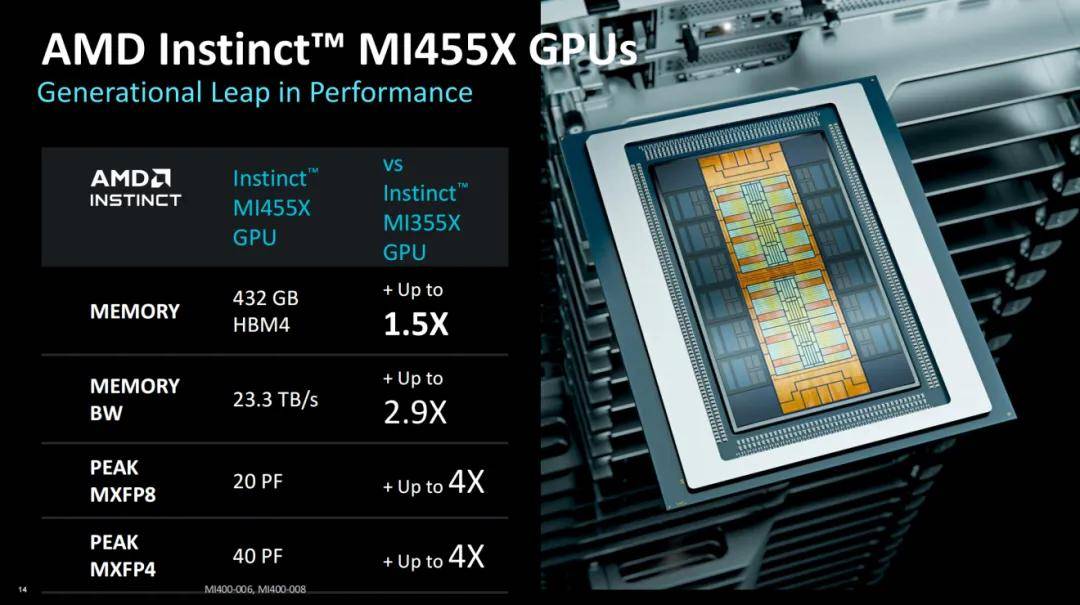
而真正体现AMD战略升维的是与MI455X配套推出的Helios机架级AI解决方案。这是AMD首款完整自主设计的机架级AI系统,整套系统由18个计算托盘和6个交换机托盘组成,通过UALink(Ultra Accelerator Link)Scale-up Fabric将72颗MI455X GPU连接在同一个计算域内。整机架FP4精度总算力达2.9 ExaFlops,HBM总容量31TB,总带宽1.7PB/s,Scale-up带宽达260TB/s。在与NVIDIA Vera Rubin NVL72的对比中,Helios在Kimi K2 Thinking工作负载(32K输入/8K输出)下,每美元Token产出最高可多出30%,在低、中、高三种交互性场景下分别实现15%、12%和10%的每GPU吞吐量优势。
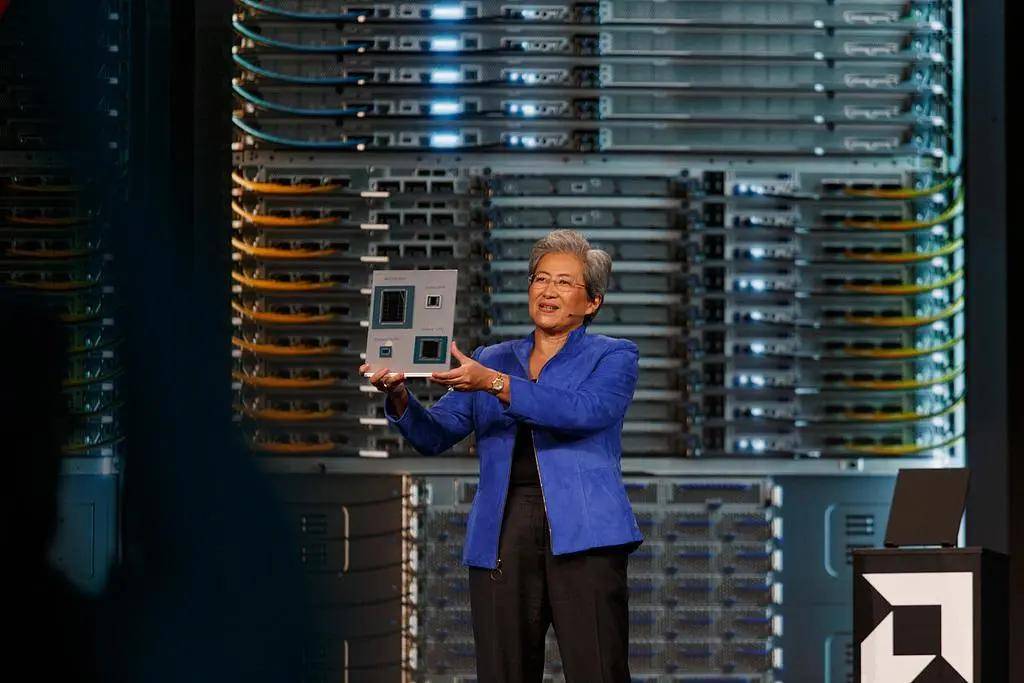
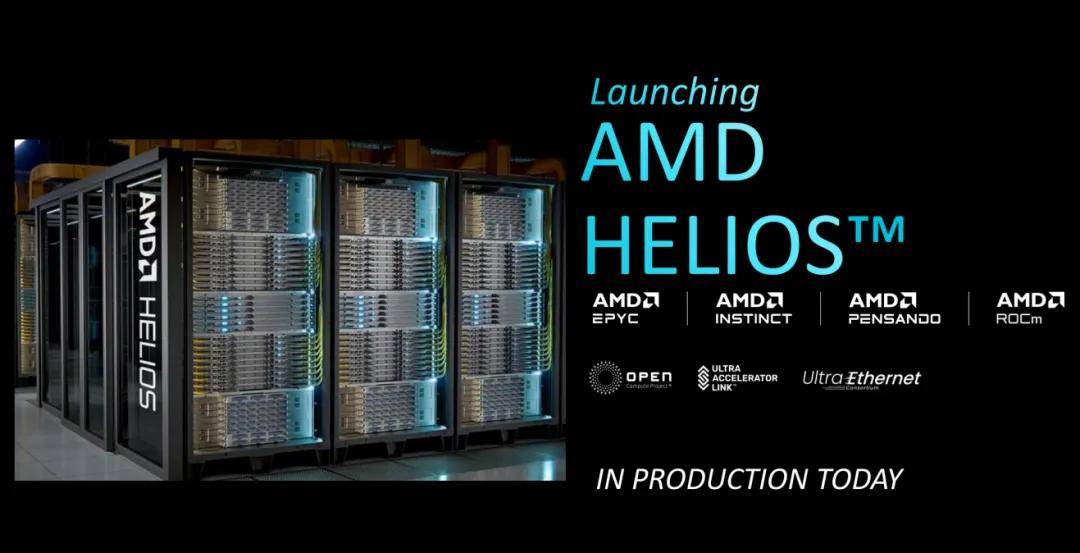
AMD的全栈硬件实力,在Helios机架系统上得到了集中释放。Helios绝不是将72颗GPU简单“塞进”一个机架,而是一次从芯片、计算、互联到系统架构的全面协同设计。围绕下一代AI工作负载,AMD从五大维度打造这一机架级AI系统:以EPYC CPU+Instinct GPU构筑领先的计算底座,以开放式机架架构打破传统封闭模式,以UALink+Ultra Ethernet构建开放网络互联,同时兼顾机架级能效与可维护性,并通过完整的生态解决方案进一步释放系统价值。
更值得关注的是,在这套AI算力系统的“大脑”位置,第六代EPYC“Venice”处理器正在扮演越来越关键的角色。在智能体AI场景、100kW机架功耗约束下,Venice的通用服务器性能达到NVIDIA Vera 88核产品的3.3倍,每瓦可承载的智能体数量更是达到基于Arm的136核AGI产品的2.8倍。
这意味着,Venice在Helios中已经不只是传统意义上的主机CPU,而是承担着智能体循环中的CPU编排与路由任务,与MI455X形成“CPU调度+GPU计算”的深度协同。CPU负责高效组织与调度,GPU负责大规模计算,两者协同之下,Helios展现出的不再是单颗芯片的峰值性能,而是一整套系统的综合算力效率。
与此同时,UALink也成为AMD构建开放AI基础设施的重要一环。作为AMD力推的开放互联标准,UALink旨在提供NVIDIA专有NVLink之外的开放选择,降低对单一供应商生态的依赖,并帮助客户降低总体拥有成本。由此来看,Helios真正想改变的并不只是“一个机架里能放多少颗GPU”,而是AI算力系统应该如何被设计、连接和扩展。
AMD挥出“软件利剑”
ROCm.AI加速突围,直指AI开发生态
如果说硬件是AMD挑战AI算力市场的“刀戟”,那么软件生态就是决定它能否刺穿NVIDIA防线的“剑锋”。在Advancing AI 2026大会上,AMD还正式推出了ROCm.AI智能开发平台,这是其开源ROCm软件栈的又一次重大升级,也是AMD向开发者社区展现出的诚意与善意。
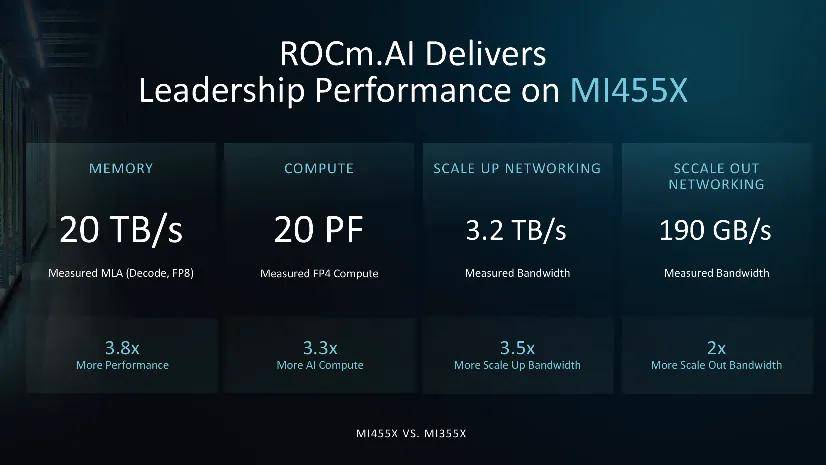
ROCm(Radeon Open Compute)作为AMD GPU计算平台的核心软件栈,在过去一年中经历了爆发式成长。根据AMD官方数据,过去一年外部开发者对ROCm开源软件栈的贡献增长了10倍以上,ROCm的发布节奏也从原来的季度更新加快到约每六周一次。在Hugging Face平台上,超过300万个模型可在AMD硬件上开箱即用;全球排名前十的开源AI项目均已原生支持AMD平台。苏姿丰在演讲中强调:“ROCm不仅是在追赶——它正在引领开放的AI革命。”
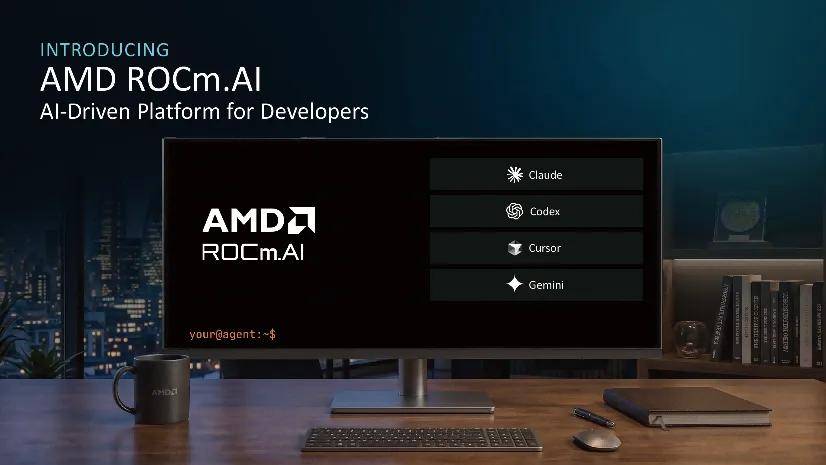
ROCm.AI的核心价值在于降低开发门槛、提升开发效率。其推理性能是ROCm 7的3.3倍,训练性能是后者的2.4倍。平台内置的分层编程体系适配了不同能力层级的开发者:对于上层应用开发者,ROCm.AI提供了与PyTorch、TensorFlow等主流框架的无缝集成;对于底层优化工程师,平台保留了充分的低级编程接口。其中最具创新性的FlyDSL技术实现了纯Python语法的GPU编程,开发者无需学习复杂的CUDA C++即可直接调度GPU算力。对于希望从CUDA生态迁移至AMD平台的开发者,AMD的HIPIFY自动化移植工具可保留平均75%的原有CUDA代码,大幅降低了迁移成本。
AMD落下关键一子
收购Taalas,向CUDA“护城河”发起突围
真正让产业界感到震动的,还有AMD在Advancing AI 2026大会结束两周后宣布的一项收购——2026年8月6日,AMD正式宣布收购多伦多AI芯片初创公司Taalas。这家公司的核心技术理念是将AI模型的权重直接蚀刻进硅片(mask-ROM),形成“模型专用集成电路”(MSIC)。Taalas的首款测试芯片HC1,采用台积电6nm工艺制造,将Meta的Llama 3.1 8B模型硬编码进硅片。初步基准测试显示,该芯片运行Meta的Llama 3.1 8B模型时效率达16960 Tokens/s,这一成绩在当时是NVIDIA GPU的48倍、Cerebras加速器的9.5倍,而成本仅为传统方案的约1/20,功耗还降低了一个数量级。
Taalas的技术路线与通用GPU形成了鲜明对照:通用GPU追求“一芯多用”的灵活性,而Taalas追求“一芯一用”的极致效率。这种“硬连线”(Hard-Wired)计算方式虽然牺牲了模型可更换性(任何重大更新都需要重新流片,但仅需更换两层金属层,成本和时间相对较低),却在推理延迟、能效比和成本结构上实现了数量级的突破。
AMD计划将Taalas芯片与Instinct GPU结合,形成分层架构:GPU处理计算密集型的提示词预处理和大上下文窗口任务,Taalas加速器负责内存带宽密集的Token生成与解码环节。这与AMD在大会上宣布的与Cerebras的“解耦式推理”联盟形成了技术呼应——两者共同指向一个趋势:未来的AI推理将不再依赖单一的通用加速器,而是由多种专用计算单元协同完成。
从战略层面看,Taalas的收购是AMD打破CUDA护城河的关键落子。NVIDIA的CUDA生态之所以难以撼动,根本原因在于其建立了一个“通用计算不可替代”的认知闭环:开发者使用CUDA编写代码,代码运行在NVIDIA GPU上,GPU的性能优势反过来巩固了CUDA的垄断地位。而Taalas的“模型即芯片”路线,从侧面瓦解了这一逻辑——它证明,在推理场景下,专用硅片可以实现远超通用GPU的效率,从而引导市场重新审视当前行业所面临的困局——NVIDIA的垄断以及CUDA依赖症。
值得注意的是,NVIDIA在数月前也以约200亿美元收购了推理初创公司Groq的资产。两大巨头不约而同地加码推理专用芯片,印证了推理市场已成为AI算力竞赛的下一个主战场。AMD的Taalas收购虽然金额远小于NVIDIA的Groq交易,但其技术路径的独特性和与ROCm开放生态的协同潜力,使其在打破CUDA护城河的战略棋局中具有不可替代的价值。结合AMD此前收购的MK1和MEXT,显然,AMD正在构建一个“软件-内存-芯片”三层推理优化矩阵,从多个维度侵蚀CUDA生态的根基。破局,已是进行时!
AMD再拓AI边界
从云端算力走向“云-边-端”全场景
值得一提的是,AMD的眼光与布局甚至并未局限于传统产品的战略升维,当大多数AI芯片厂商仍在云端训练与推理的战场上厮杀时,AMD已经将目光投向了更具想象空间的物理AI(Physical AI)领域。
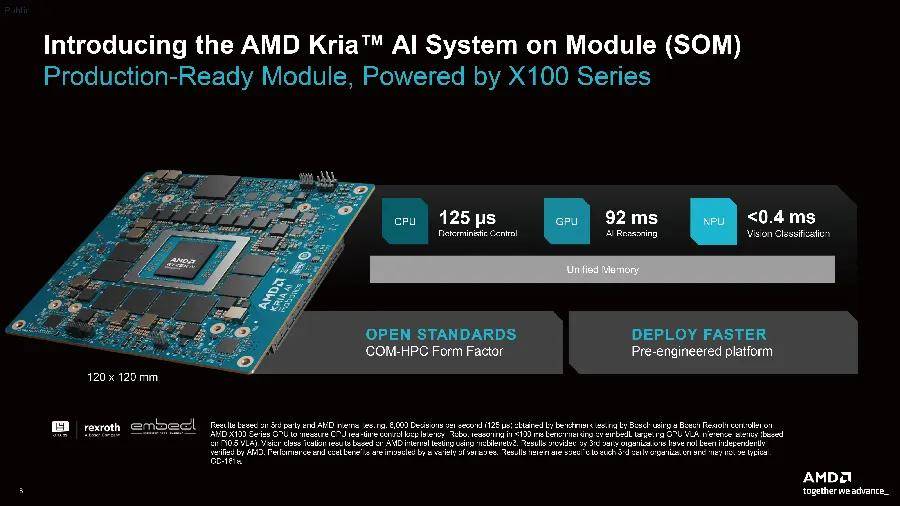
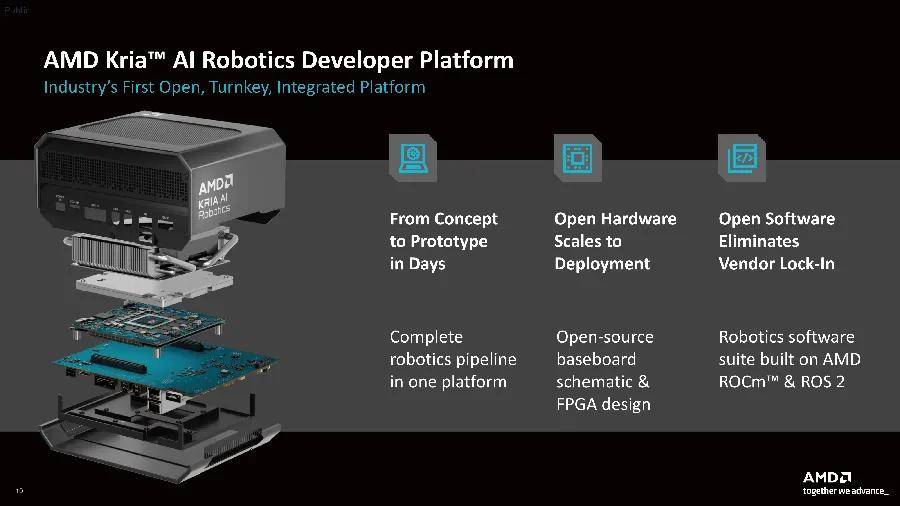
在Advancing AI 2026大会上,AMD推出了面向自主机器人的Kria AI解决方案,包括锐龙AI嵌入式X100系列处理器、Kria AI系统级模块(SOM)、Kria AI机器人开发者平台,以及配套的AMD机器人软件套件与机器人合作伙伴网络。AMD预测,物理AI硅片市场将在2035年达到2000亿美元的规模。Kria AI的推出,标志着AMD正从传统的云端算力供应商,向覆盖“云-边-端”全场景的AI计算平台提供商转型。据悉,首批已有超过30家产业链企业入驻AMD机器人合作伙伴网络,包括ABB、FANUC、Kawasaki和Universal Robots等工业自动化巨头。
总体而言,AMD在Advancing AI 2026上展现了覆盖芯片、系统、软件与生态的全栈AI布局。随着推理成为AI基础设施发展的重要驱动力,市场对于低延迟、低成本、高能效的创新算力产品,以及开放架构和专用推理技术的需求持续提升,也为AMD提供了更广阔的差异化发展空间。与此同时,Anthropic、OpenAI、Meta三大前沿AI公司均与AMD达成大规模算力合作,头部AI企业的持续选择与深度合作,进一步彰显了AMD产品与平台面向前沿AI工作负载的竞争力,也体现出AMD在全球AI基础设施市场中的影响力正在持续提升。
在开放标准层面,AMD力推的UALink正在获得产业支持。UALink作为NVLink的开放替代方案,已被纳入Helios机架系统的设计中,支持多平面Fabric和冗余路径。AMD还与Cerebras Systems建立了技术合作伙伴关系,将Helios与Cerebras的晶圆级引擎整合到单一推理工作流中。此外,AMD与Cisco的合作将AMD高性能推理引擎与Cisco的网络、可观测性和安全能力相结合,直指企业AI落地过程中的网络、安全与治理痛点。
从“芯”到“架”再到生态
AMD开启AI算力第二次蜕变
过去十余年,AMD完成了一次足以改变自身命运的蜕变,从传统芯片厂商一路成长为AI与高性能计算领域的重要参与者。而站在AI智能体时代加速到来的今天,AMD显然不再满足于做一个时代的参与者,而是将目标进一步指向“AI基础设施提供者”。
这一次,AMD押注的已经不是某一颗芯片、某一款GPU,而是一套完整的AI算力体系。从CPU、GPU到网络、软件,再到机架系统,AMD正在通过全栈协同,将分散的硬件能力整合为面向下一代AI工作负载的完整算力底座。Instinct MI455X与Helios,展现了AMD在系统级硬件上的全面进阶;ROCm.AI与Taalas,释放了AMD在软件生态和专用推理技术上的更大野心;第六代EPYC“Venice”与Kria AI,则进一步将AI计算能力从数据中心延伸至智能体主机节点乃至物理世界。
因此,Advancing AI 2026的意义,远不止于一次新品发布。它更像是AMD全栈AI战略的一次集中亮相,也是AMD向“AI基础设施提供者”跃迁的重要节点。芯片只是起点,系统才是战场,生态则决定最终的竞争边界。
当推理成为AI算力增长的新引擎,当竞争从单卡性能升级到机架级系统,当开放标准开始与封闭生态正面交锋,AI算力产业正在迎来一场深刻的范式重构。
第一次蜕变,让AMD走到了今天;第二次蜕变,则正在决定AMD的下一个时代。以Advancing AI 2026为新的起点,AMD已经吹响了向AI基础设施纵深进击的号角。CUDA的护城河并非不可撼动,而AI算力竞争真正精彩的下半场,才刚刚开始。