端侧智能体AI市场的竞争来到新阶段。9月底,第一批搭载AMD锐龙AI Max+ PRO 495处理器的迷你AI工作站即将上市。一个月后,NVIDIA新推出的同类型产品RTX Spark Windows PC也将正式开卖,这意味着AMD和NVIDIA在迷你AI工作站市场正式相遇。对消费者而言,前有锐龙AI Max+ PRO 495迷你AI工作站,后有NVIDIA RTX Spark,都是端侧智能体AI主机,它们谁更有优势更值得选择呢?今天我们就从硬件配置、软件生态等各个方面为大家分析一下。
硬件配置
AMD平台192 GB大内存更有价值
从硬件方面来看,锐龙AI Max+ PRO 495平台与RTX Spark平台均采用集成式设计,在紧凑的平台中提供CPU和GPU计算能力,二者的形态都以迷你AI工作站或者笔记本为主。
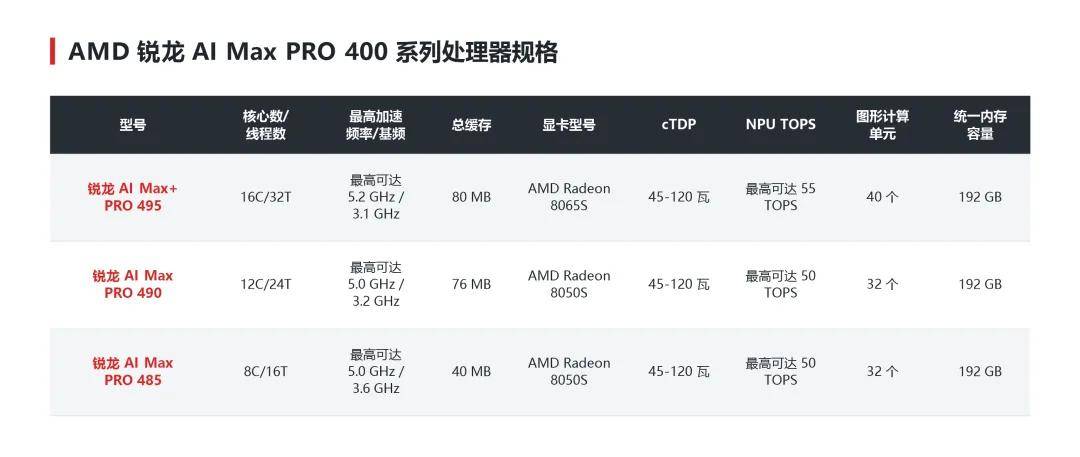
在具体的配置上,锐龙AI Max+ PRO 495处理器基于AMD Zen 5架构、4 nm生产工艺,采用全大核设计,配备16核心32线程,最高加速频率达到5.2 GHz;集成基于RDNA 3.5架构的Radeon 8065S显卡,其配备40组计算单元。锐龙AI Max+ PRO 495处理器还集成基于XDNA 2架构的新一代NPU,其最高算力达到55 TOPS。
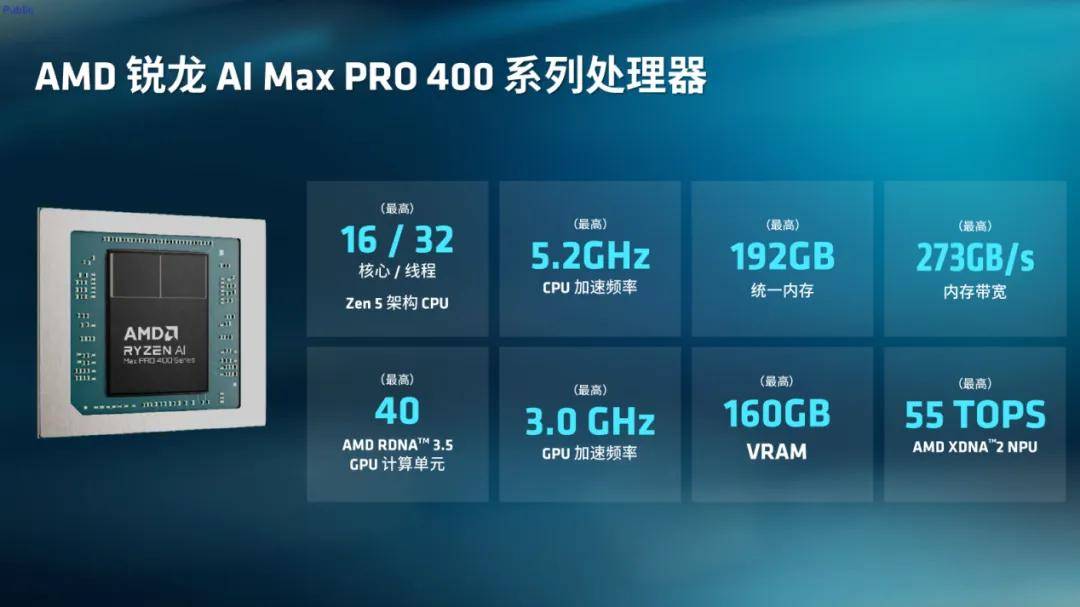
除了处理器的相关配置,锐龙AI Max+ PRO 495平台最亮眼的是内存规格。该平台支持最高192 GB统一内存(上一代395平台最高支持128 GB内存),搭配AMD VGM可变显存技术,其中最高160 GB可划拨为显存。AMD表示这是“首款能够在本地运行3000亿参数(300B)模型的x86客户端处理器”。
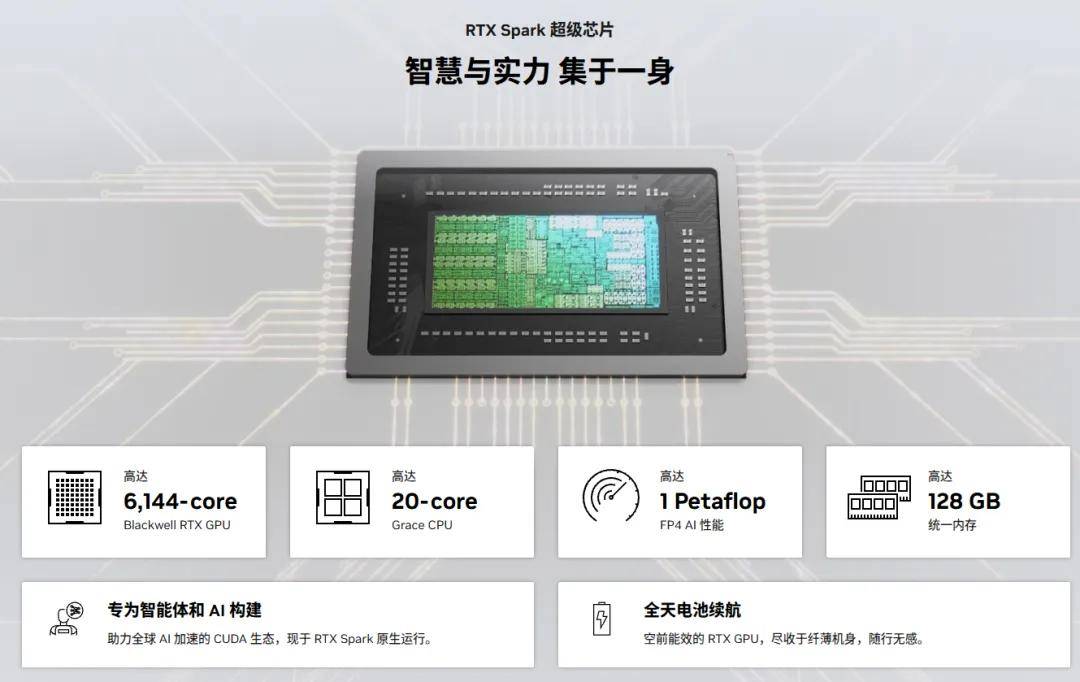
NVIDIA RTX Spark走的是另一条路线。根据NVIDIA公布的规格,RTX Spark超级芯片采用拥有20核心的Grace CPU(Arm架构)以及拥有6144个CUDA核心的Blackwell GPU,平台最高支持128 GB LPDDR5X统一内存,运行Windows 11 on Arm系统,平台标称最高1 PFLOP算力。
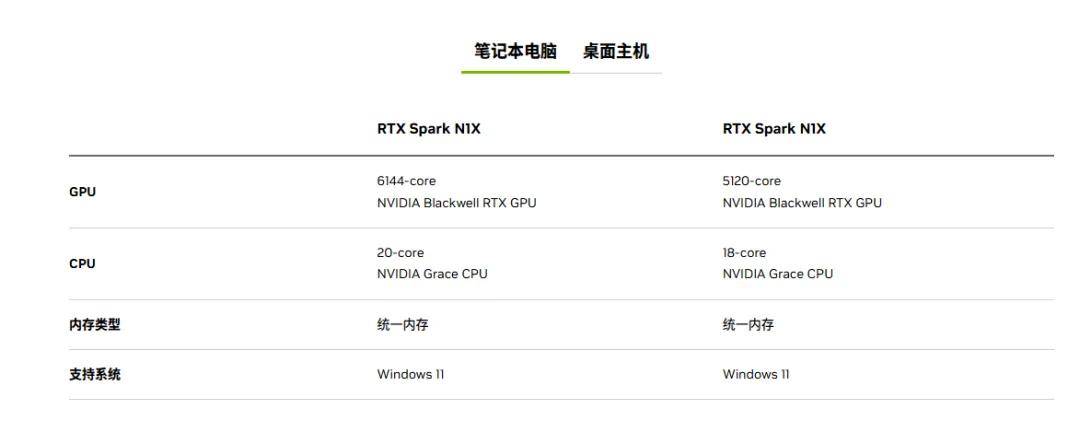
NVIDIA RTX Spark平台最高支持128 GB统一内存继承自DGX Spark的规格,本地模型规模停留在最高2000亿参数(200B)级别,官方主推模型规模更是仅有120B,而且128 GB配置只出现在高配版本上,低配版本的GPU缩减至5120个CUDA核心,内存支持的上限也更低。
可见,在硬件规格上,NVIDIA RTX Spark平台的CPU和GPU核心数量看上去更多,但是二者的CPU采用不同的架构(x86和Arm),GPU的规格也不同,实际性能还有待实测。抛开这些传统的规格参数,锐龙AI Max+ PRO 495平台对比NVIDIA RTX Spark平台最大的亮点是内存容量的不同。
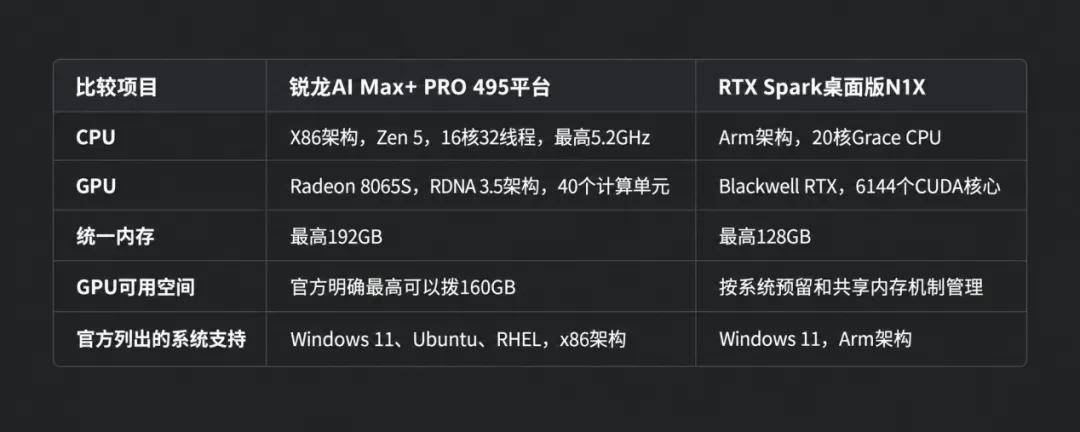
这两款产品共享同一个设计哲学——统一内存架构,让CPU与GPU共用同一个大内存池(AMD平台还有NPU),从而摆脱传统独显显存容量的束缚。不过AMD这一次直接把容量天花板抬高了50%,达到夸张的192 GB统一内存,而且最多可以划拨160 GB作为GPU专用显存。然而,NVIDIA RTX Spark平台最高只支持128 GB统一内存,锐龙AI Max+ PRO 495平台比它多64 GB。
对于本地大模型部署,这一差距首先意味着可选择的模型范围更大。AMD表示,锐龙AI Max+ PRO 495平台在最高160 GB显存的条件下能够以4-bit量化方式运行3000亿参数级别(300B)的大模型。而NVIDIA RTX Spark平台只能在本地运行2000亿参数级别(200B)的大模型。
对智能体应用而言,更大容量也可以用于保留运行空间。模型之外,上下文缓存、文档处理和其他程序同样消耗资源。用户在实际使用的过程中未必需要选择容量上限对应的最大模型,也可以使用较小模型,将剩余空间留给更复杂的工作流程。
AMD高级副总裁、客户端业务总经理Rahul Tikoo此前在采访中提到一个场景,说的是锐龙AI Halo级别的机器可以在任意时间点让6到10个智能体同时运行——一个智能体规划任务、一个调用代码工具、一个做检索以及一个核对结果等,它们彼此协作。这种“智能体群”模式对内存的胃口远超单模型聊天,因为每个并发实例都要占用模型权重和KV缓存,而且长上下文会让占用继续膨胀。所以,智能体AI时代的“智能体群”模式进一步增加了资源分配的复杂性。不同智能体可能共享同一个模型服务,也可能调用不同模型,分别处理文本、图像或专业任务。因此,内存容量增加之后为锐龙AI Max+ PRO 495平台提供了更大的配置余地。
x86还是Arm?
这对企业用户很重要
锐龙AI Max+ PRO 495平台与NVIDIA RTX Spark平台最大的差别还在于硬件架构上。NVIDIA RTX Spark平台是Windows on Arm阵营迄今最受关注的产品,黄仁勋甚至在ComputeX展会上承诺“它真的能运行这个世界上曾经创造过的所有程序”,微软也在配合扩充兼容目录。
尽管目前Windows on Arm已经通过Prism显著改善x86/x64应用的转译性能,微软称其可降低转译应用的CPU占用,并较此前的Windows转译技术带来明显提升;但转译性能的实际表现依然会随应用类型、指令集使用情况和驱动依赖而波动。对依赖AVX/AVX2、专有驱动或老旧企业软件的专业负载而言,原生Arm64适配与兼容性验证仍是不可绕开的环节。
当然,NVIDIA也有自己的优势,CUDA Toolkit 13.4(开发者预览版)已经为AArch64的Windows原生重建。x86的CUDA二进制可以免重编译直接在RTX Spark平台运行,PyTorch、TensorRT-LLM这些主力框架也原生可用。不过正如上面所说,企业安全代理、行业外设驱动以及硬件加密狗等内核级驱动无法转译,这是企业IT采购最常见的硬阻塞。另外就是部分游戏的内核反作弊软件可能也无法运行,再有就是Prism转译会带来性能的损失,这些都是Windows on Arm阵营不可避免的问题。
对于普通消费者而言,也许可以等待生态补齐,但对于要在企业里批量部署、要跑设定好的行业软件的IT部门而言,兼容性风险就是真金白银的成本。而锐龙AI Max+ PRO 495平台采用原生x86架构,对已有大量x86软件的组织/团队而言,锐龙AI Max+ PRO 495平台延续了熟悉的处理器架构,并提供Windows与Linux支持。这有助于减少切换CPU架构时需要新增的适配工作,也便于开发和运维人员沿用部分工具与经验。
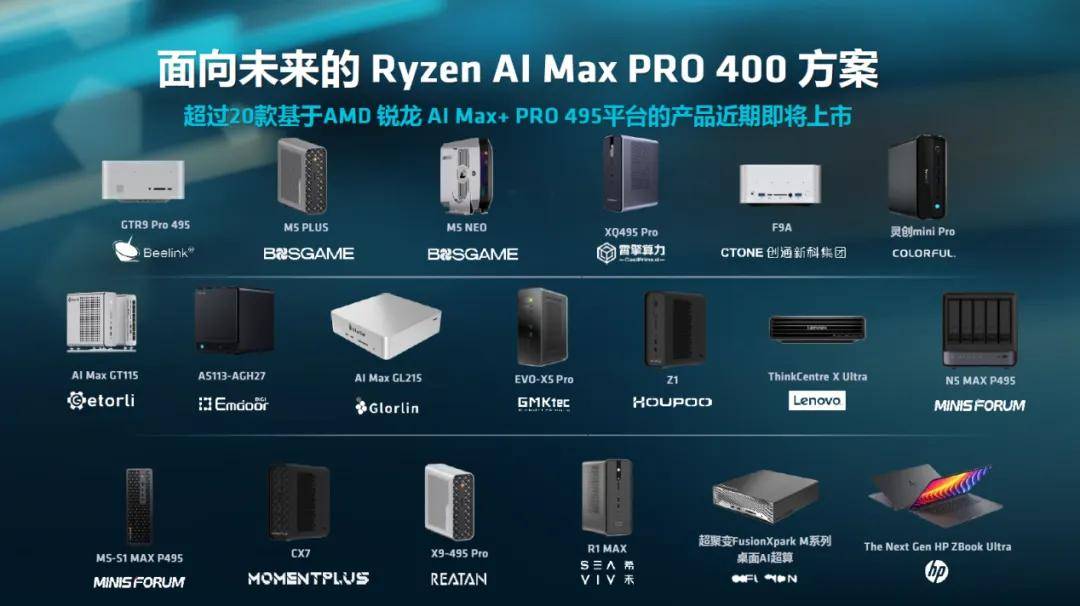
另外,在设备端,AMD的OEM覆盖更广泛,这为用户提供了更多选择。比如在2026年9月10日的沙龙上,联想、超聚变、铭凡和极摩客等合作伙伴集中展示了9款基于锐龙AI Max+ PRO 495平台的产品,AMD预计近期将有超过20款相关新品上市。这些不同的OEM可以围绕体积、接口、存储、散热和服务为消费者带来丰富的产品。
生态之争
CUDA的护城河vs ROCm的开箱即用
在软件生态上,NVIDIA的CUDA生态确实有着独特的优势,不过AMD也在积极发展自己的软件生态。在今年ComputeX期间的采访中,AMD高级副总裁、客户端业务总经理Rahul Tikoo多次提到开发者的环境配置负担:为了让一个智能体项目正常运行,开发者可能需要花费数天查阅文档、安装依赖和排查问题。
AMD为此推进的工作包括让ROCm实现对全主流AI框架的day 0首发适配、Halo开发者平台上的Playbooks、开发者中心以及定期提供的“最佳已知配置”。其作用是将经过验证的软件组合交给开发者,减少反复尝试环境配置的时间。Rahul表示,这些软件成果计划在Halo完成调优和稳定性验证后,扩展至AI Max系列的笔记本、工作站和台式机。这为锐龙AI Max+ PRO 495产品的软件准备提供了一条路径。
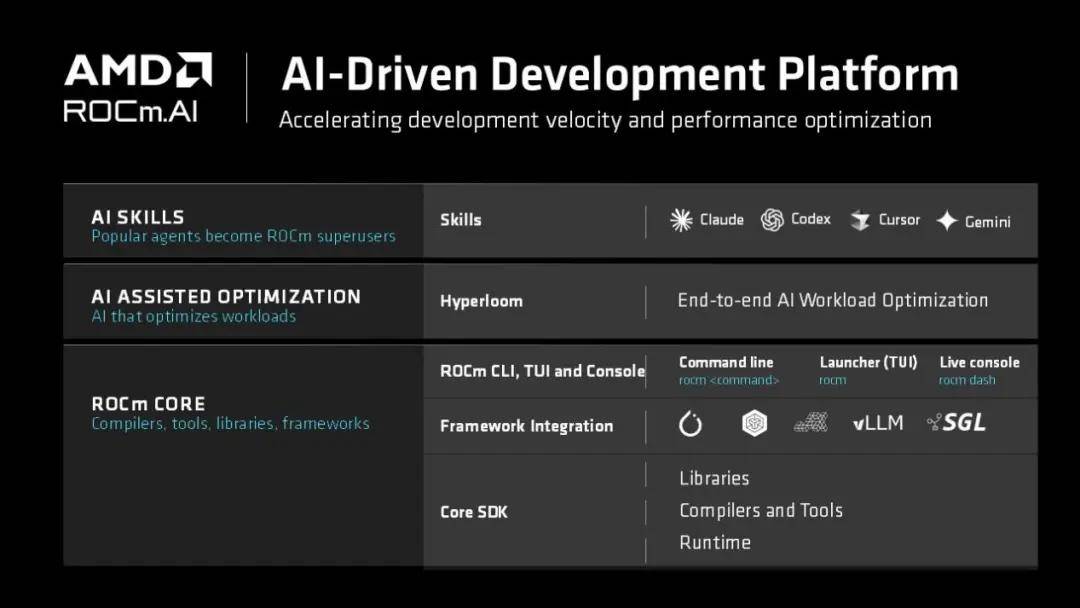
更重要的是,在软件层面,AMD正在积极补齐“客户端本地AI”的软件短板——2026年8月正式推出ROCm 10.0,将其打造为面向AI推理、智能体、开发工具和跨平台部署的AI-native平台。目前,AMD已经将Gorgon Halo纳入ROCm 10的正式支持范围,开发者可以沿用ROCm、HIP与主流开源推理框架的既有路径,而不必等待一个独立的软件分支成熟。
生态与商业落地
AMD的先发优势
2025年,AMD在CES上正式发布锐龙AI Max系列处理器时,“桌面芯片跑本地大模型”还是个没人验证过的概念。AMD高级副总裁、客户端业务总经理Rahul Tikoo后来回忆,此后近两年AMD“几乎是这一领域唯一的参与者”。这期间,AMD在积极联合合作伙伴把品类的地基打实。
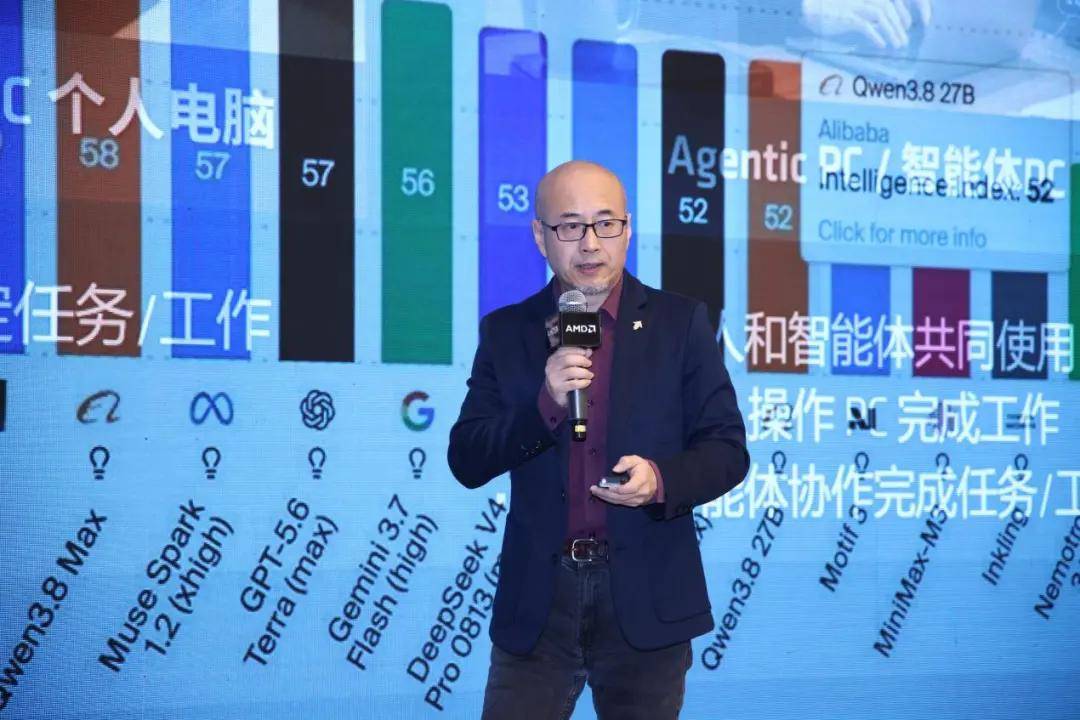
2026年9月10日,AMD在北京举办的媒体沙龙就是最好的成绩单。会上,CSDN、首界科技、星漪科技、生寰未来、昆仑元、六联智能、赛博物联和创造进化等伙伴带来了众多由锐龙AI Max平台赋能并落地的智能体AI方案。
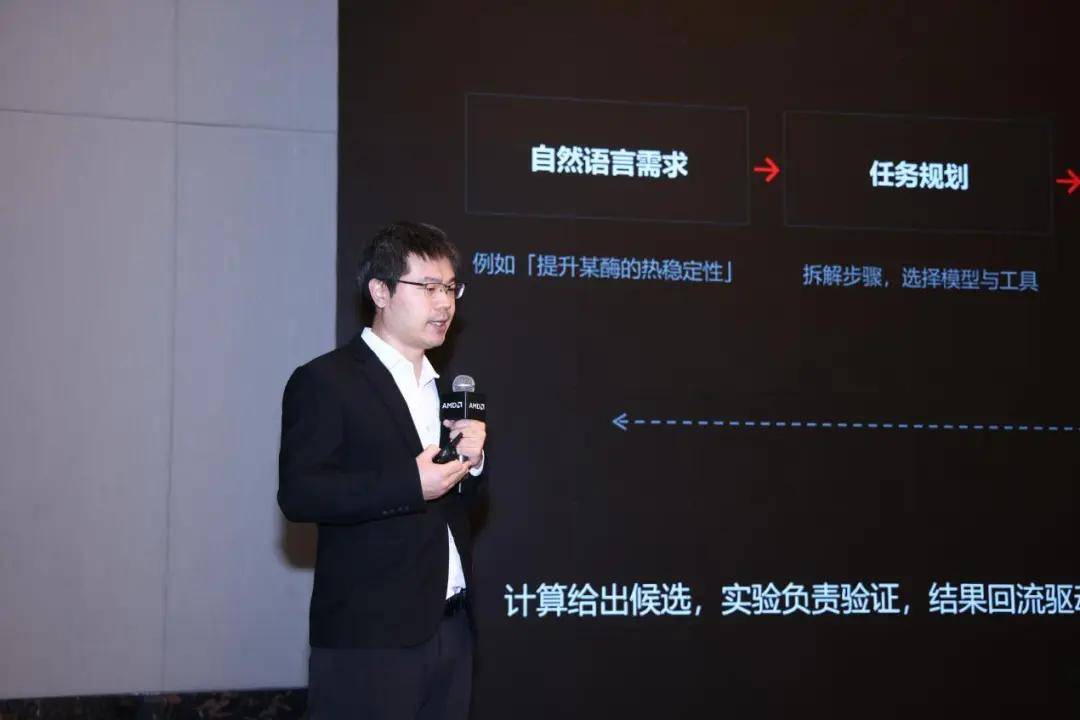
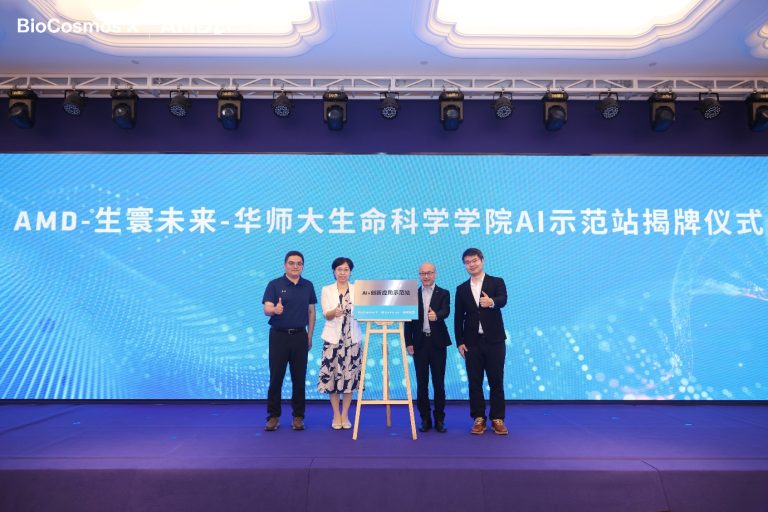
比如在教育与科研场景,生寰未来创始人兼CTO陈帅华博士展示的Protalgen蛋白质设计智能体是最能体现端侧算力价值的案例之一。研究者用自然语言描述目标,系统完成任务理解、模型编排、候选设计与评估报告生成,再由实验验证。锐龙AI Max+ 395平台提供三重支撑——128GB统一内存把千亿参数级模型装进校内设备,GPU扛批量推理、NPU跑常驻伴学助手、CPU兜底复杂调度,全程离线本地计算让未公开成果不出校门。实现的效果是过去一套方案要摸索数月,现在AI先算后试,几天就能给出候选结果。该方案即将整体落地华东师范大学生命科学学院。
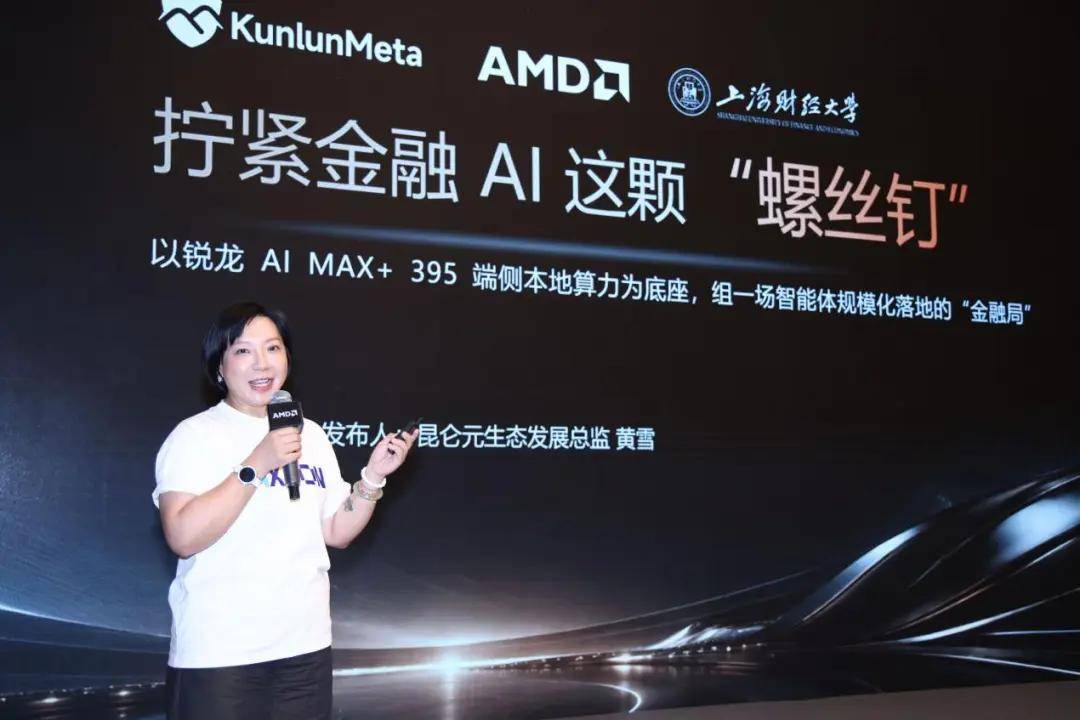
在金融场景中,昆仑元AI生态发展总监黄雪介绍,昆仑元与上海财经大学金融智能研究院、AMD围绕端侧金融智能体展开协同:AMD锐龙AI Max+ 395平台提供本地算力,昆仑元的GPT-Station、KLLMQ推理框架和智能体工程能力负责安全运行与任务编排,FinBot则把投资检索、量化研究、组合归因、合规风控和文档处理封装成可调用的专业技能。大模型负责理解意图和组织流程,确定性工具承担计算与校验,从而在不让敏感数据离开设备的前提下,提升金融任务的专业性、可解释性和可追溯性。
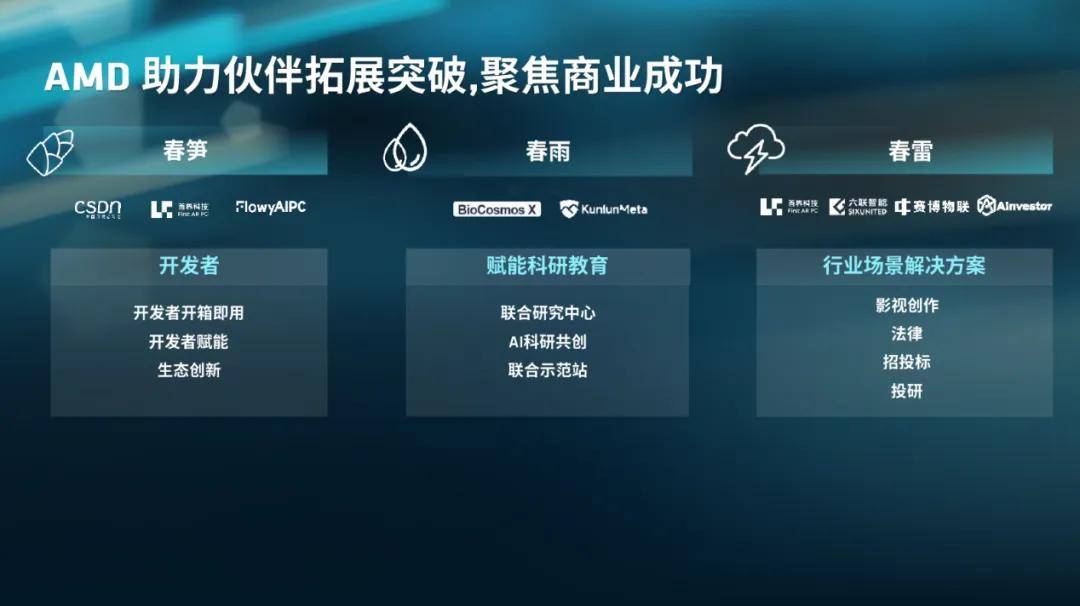
撑起这一切的是AMD大中华区市场营销副总裁纪朝晖在现场梳理的锐龙AI Max智能体主机赋能端侧创新的四个主要项目:春雷计划、春雨计划、春笋计划和智能体创新应用大赛。据介绍,“春雷计划”面向行业场景,与合作伙伴共创解决方案,覆盖投标、保险、投资、影视、医疗、教育、科研、安防、数据分析、供应链、审计和财税等领域,已推出20余种解决方案;“春雨计划”已走进百余所高校,通过AI微讲座、实训教室、ROCm培训、创新示范中心和专项竞赛等,将端侧算力融入教学与科研;“春笋计划”连接AI社区和开发者活动,推动模型、工具与应用经验开放流动,持续扩大AI影响力;AMD锐龙AI智能体创新应用大赛则为超级应用和“超级个体”提供从创意实现到产品推广的展示平台。
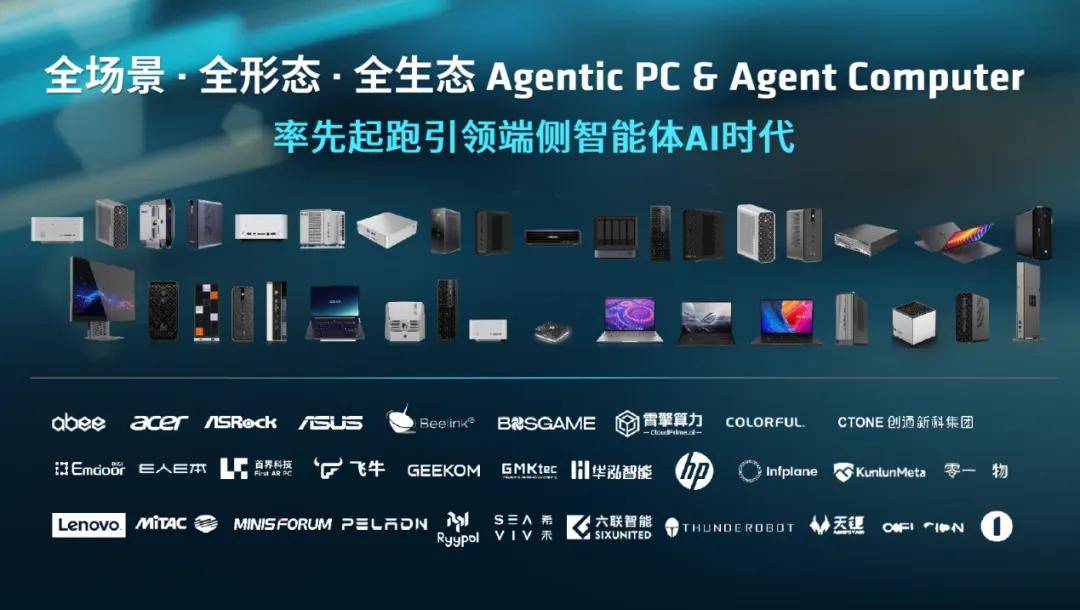
硬件形态层面,AMD的伙伴矩阵同样在变大。六联智能围绕AMD平台构建了从迷你主机、1L/2L工作站到笔记本、平板、一体机和AI NAS的全线产品矩阵。联想、超聚变、铭凡、极摩客、Emdoor、七彩虹和阿迈奇等伙伴的9款锐龙AI Max+ PRO 495平台新品已经在9月10日现场完成首秀,近期预计将有超过20款基于锐龙AI Max+ PRO 495平台的新机型陆续上市。而锐龙AI Max系列发布以来,AMD与OEM合作伙伴已推出超过35款不同形态的产品。
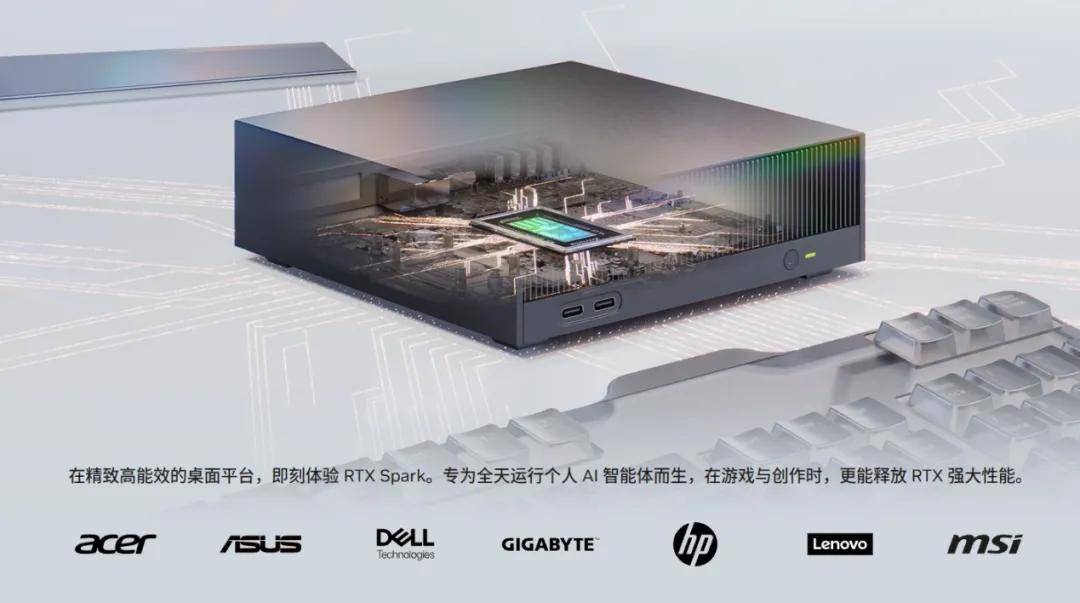
反观NVIDIA这边,RTX Spark目前处于发布但未开售状态。NVIDIA在9月上旬IFA期间披露,搭载RTX Spark N1X芯片的Windows PC预计10月起陆续上市,阵容有华硕、联想、宏碁、微星、戴尔、惠普乃至微软自家的Surface。这份OEM名单足够豪华,但一切才刚起步,基于RTX Spark平台的行业解决方案还没在客户业务里跑过,也谈不上有开发者社区围绕这个平台沉淀出经过验证的工作流。尽管NVIDIA在DGX Spark上积累了约一年的开发者社区,但它与主打Windows 11 on Arm的RTX Spark在系统、生态和用户群上并没有交集。用一句话来总结,NVIDIA RTX Spark还在起步阶段。
AMD锐龙AI Max这条产品线反而已经走完了从发牌、上牌桌到下注的完整周期。2025年CES发布第一代Strix Halo,已有35款以上OEM产品铺开,2026年第二代Gorgon Halo接棒,统一内存从128 GB/96 GB显存升级到192 GB/160 GB显存,支持的本地模型规模从200B跃升到300B。更重要的是,过去一年围绕锐龙AI Max+ 395平台发展出来的开发者工具链、行业解决方案、高校合作项目、应用大赛和大量的渠道出货全部可以无缝继承给锐龙AI Max+ PRO 495这一代。用投资的语境来讲,这是AMD一年多生态经营的复利。
写在最后
端侧智能体主机在智能体AI时代需要承载模型,也需要让模型与资料、工具和业务程序持续配合。沿着这条需求来看,锐龙AI Max+ PRO 495平台相对NVIDIA RTX Spark平台的优势相当明显。192 GB统一内存扩大了本地部署空间,x86 Windows与Linux环境便于延续既有工作方式,锐龙AI Max生态下的伙伴方案则提供了可以继续拓展的应用基础。
这些优势对于长文档处理、多模型应用和已有x86业务环境的用户尤其值得评估。NVIDIA RTX Spark也有自己的优势,不过它还处于刚开始的萌芽阶段。对整个行业来讲,NVIDIA的加入会让产业更确信端侧AI有实际价值,而且这一市场值得持续投入;PC可以承担越来越多AI工作。而AMD和NVIDIA同时投入,也一定会促进PC、Windows以及AI框架生态的发展。
对普通消费者和企业采购来说,现在的选择反而简单。愿意等新生态成熟的,可以看NVIDIA RTX Spark;想要马上把多智能体工作流部署到位的开发者和企业,以及想要业务无缝衔接的开发者和企业,显然已经上市的锐龙AI Max+ 395平台和即将上市的锐龙AI Max+ PRO 495平台是目前最好的选择。