9月22日到9月24日,一年一度的阿里巴巴云栖大会在杭州举办。与往年不同的是,今年智能体成为云栖大会的主旋律。上到主论坛的大模型发布,下到各个展区的应用演示,智能体几乎无处不在。当一个智能体在几秒钟内完成思考、检索、规划和执行,它的背后往往涉及多次模型调用、海量数据访问以及复杂的资源调度,一场围绕基础设施的演变也随之展开。9月23日,英特尔数据中心集团副总裁、中国区总经理陈葆立领衔,连同英特尔多位技术专家与阿里云多位一线专家,在云栖大会的分论坛分享了双方在智能体AI领域的最新进展。
Agent元年:CPU为什么“回来了”?
智能体AI是今年非常火的话题,今年也被称为智能体AI元年。陈葆立在开场致辞中抛出一组数字:预计到2026年底,超过80%的企业应用将至少嵌入一个智能体;而IDC更是给出一个大胆预判——到2031年,中国企业场景中活跃的智能体数量将达到3.5亿个。
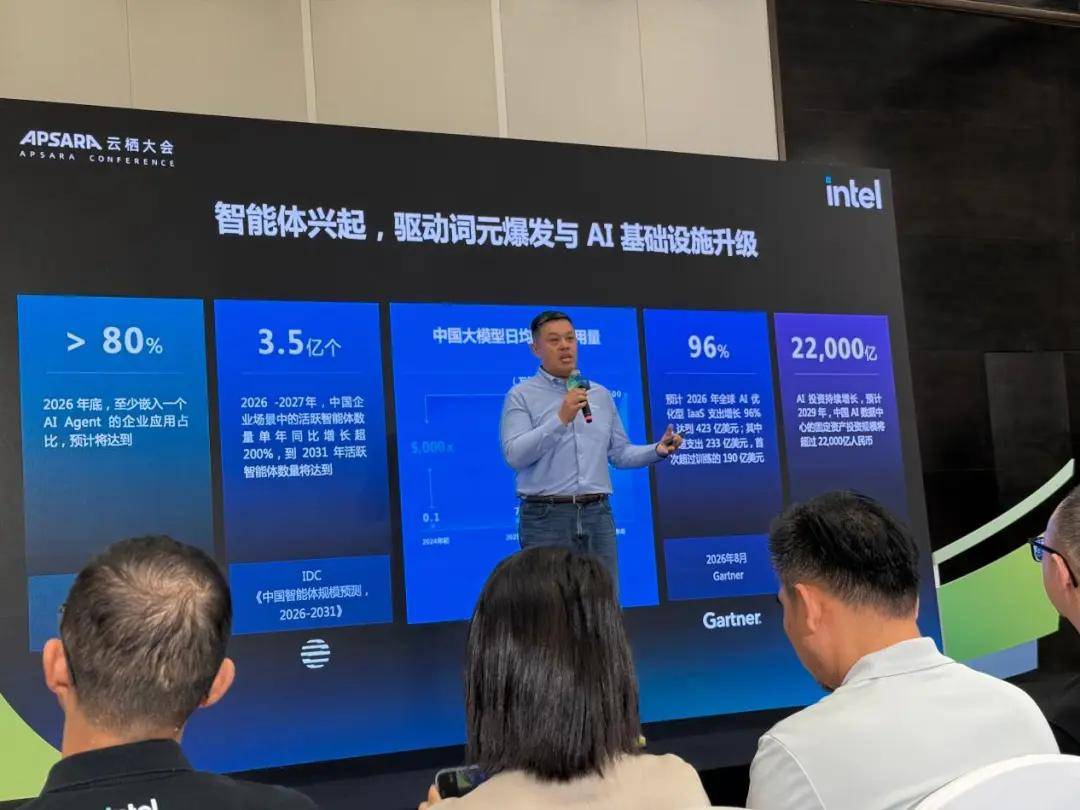
另外,还有数据显示,目前中国大模型的日均Token调用量从2024年初的0.1万亿增长到500亿;预计2026年全球AI优化型IaaS的支出也将同比增长96%。而美银证券更是预测,到2029年,中国AI数据中心的固定资产投资规模将超过2.2万亿元。
这些数字背后,是智能体工作负载对传统推理模式的根本性改变。传统单轮推理更像是一次提问、一次生成,AI像个“没有记忆的天才”,计算大头集中在GPU上,CPU只负责前后的准备与交付。而智能体是一个持续运行的流程——思考、规划调度、执行以及反馈,每个环节的算力特征完全不同,其中规划调度、工具调用以及反馈处理等环节主要靠CPU承担,整个流程是CPU与GPU协同和反复迭代的结果。
从今年年初OpenClaw、WorkBuddy等Agent应用的爆火以及最近千问办公、豆包办公等AI工具的密集上线都可以看出,这背后是提示词工程、上下文工程、Harness工程以及循环工程等一层层软件的演进,而更深层次的背后,很多工作其实需要靠CPU来参与。
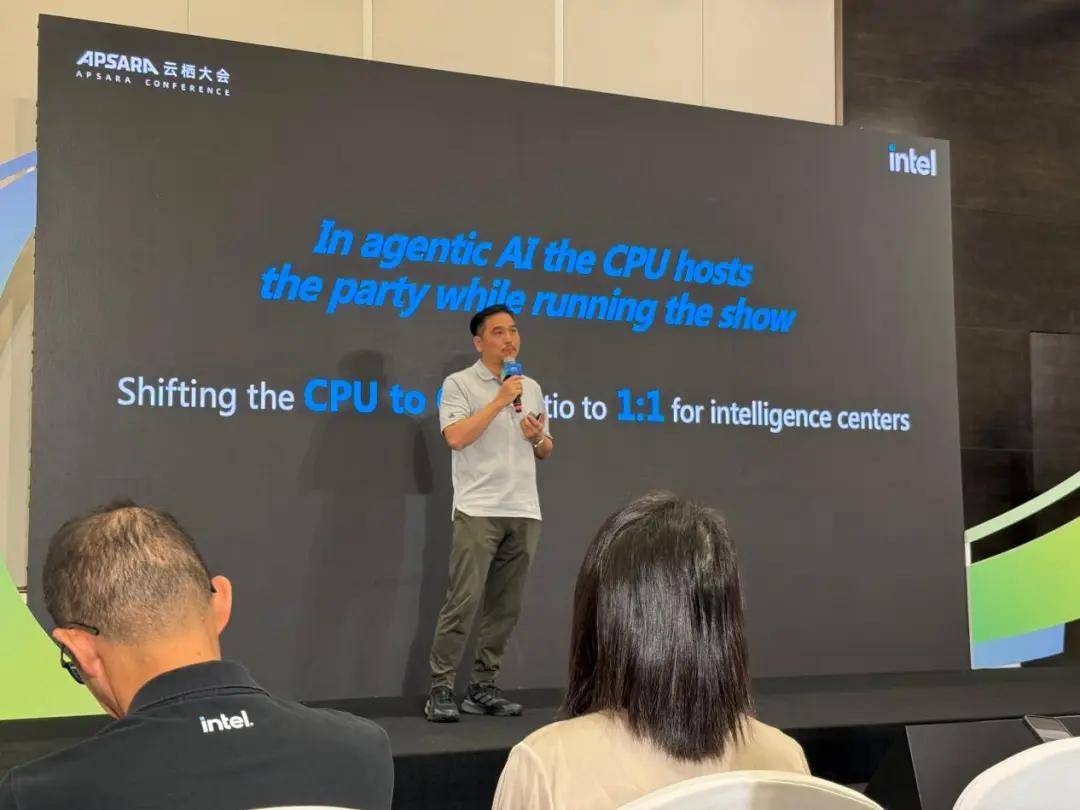
“进入智能体时代之后,CPU既是主办方也是调度者。”英特尔技术专家李尔成引用业界观察指出,数据中心里CPU与GPU的配比,正从传统的1:4向1:1演进,部分场景下CPU数量甚至可能超过GPU。与此呼应,不少机构预测到2030年,数据中心80%的工作负载将与AI相关,而AI业务的占比也将从2025年的23%提升到50%——其中推理类负载将占37%,智能体正是主要推手。
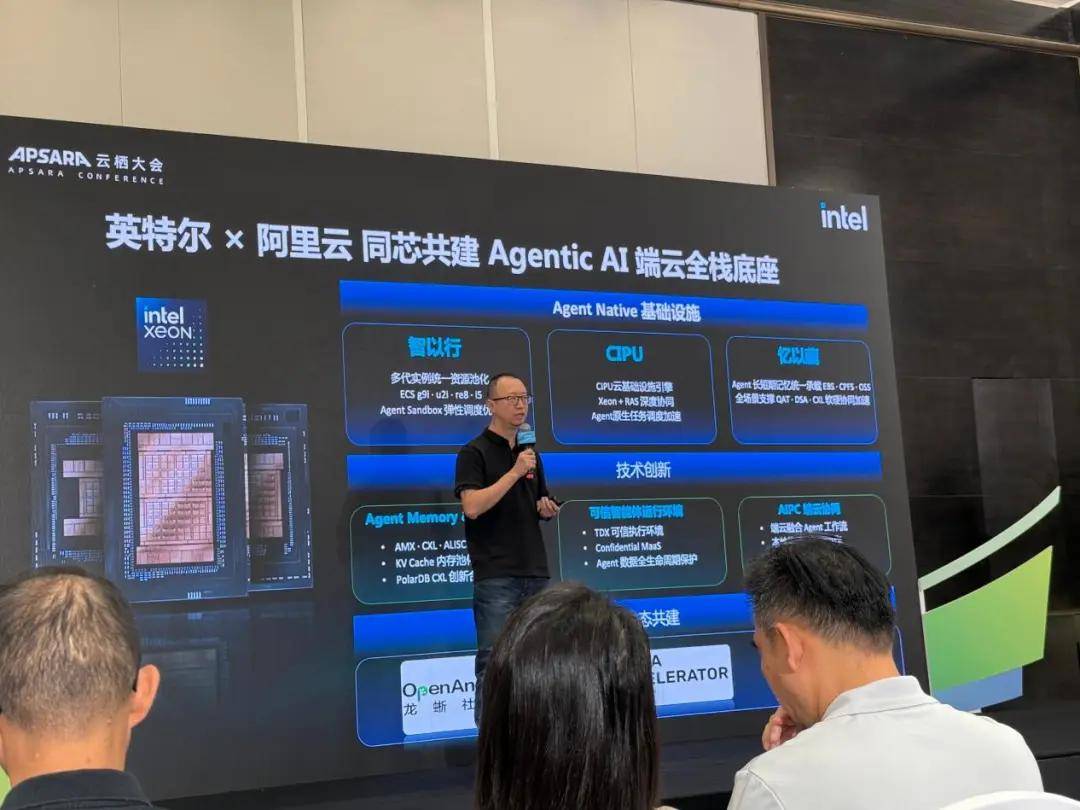
阿里云智能集团首席服务器架构师卓久从用户视角印证了这种趋势。“过去主要是人在使用AI,使用规模有限;但未来会有更多机器之间、Agent之间的交互,这会推动AI需求进一步爆发式增长。从今年3月到现在,我们已经看到了明显的CPU爆发趋势。”他强调,这一波波AI浪潮带来的不只是对GPU,同样也是对CPU、存储和内存的需求,这是一个全链条协同的问题。
至强6与至强6+撑起“三集群”
有机构预测,企业级x86服务器装机量预计将从2025年的约6300万台增长到2030年的约7600万台,占全球服务器装机量的约80%。毫无疑问,这些仍在增长的通用计算资源正是AI下一阶段发展的坚实基础。面对这广阔的市场,英特尔提供了完善的产品布局。
在陈葆立看来,目前整个AI数据中心可以简化为三类集群,即CPU集群、GPU集群和存储集群。CPU集群负责智能体任务的执行与编排;GPU集群负责模型计算;存储集群负责数据存储与“记忆”。这三者的共同点是都需要CPU参与调度和数据传输,这正是英特尔现有产品矩阵的卡位逻辑。
据李尔成介绍,至强处理器为端到端的智能体流程提供支撑,覆盖上下文(RAG、向量检索、数据库以及预填充)、推理(20B以下小模型推理、模型路由和Token生成)、执行(工具调用、API、事务和工作流)和治理(身份、策略、护栏以及安全控制面)四个环节。
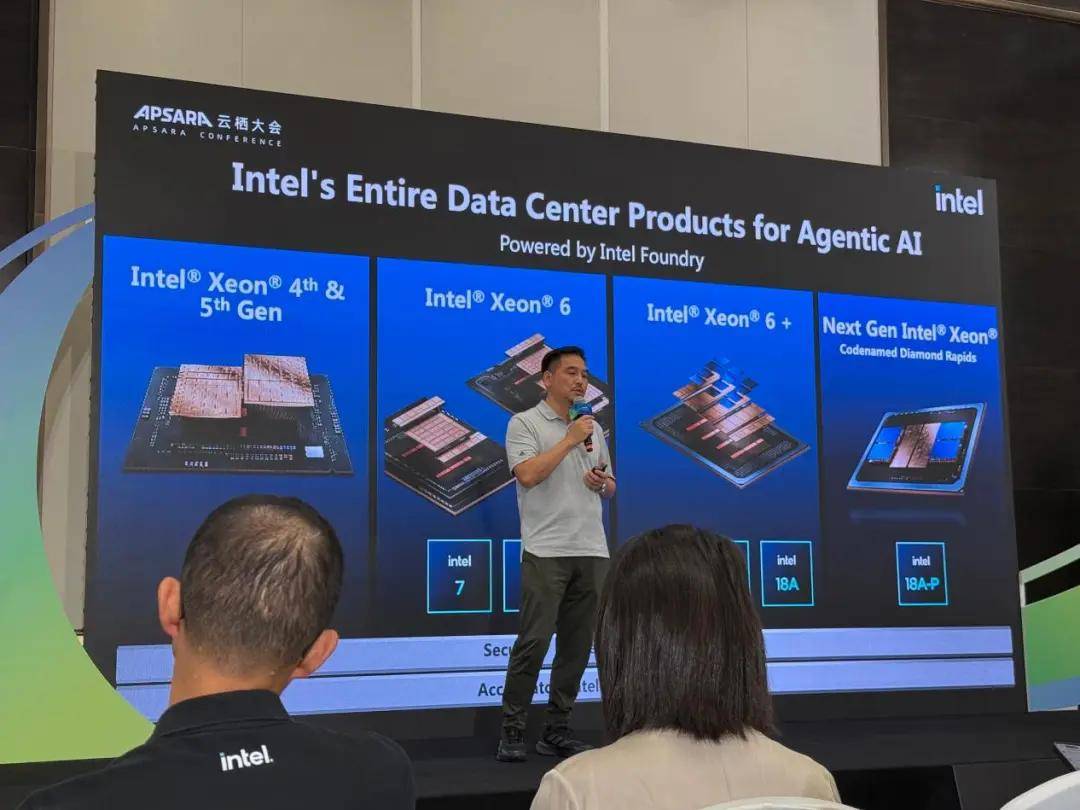
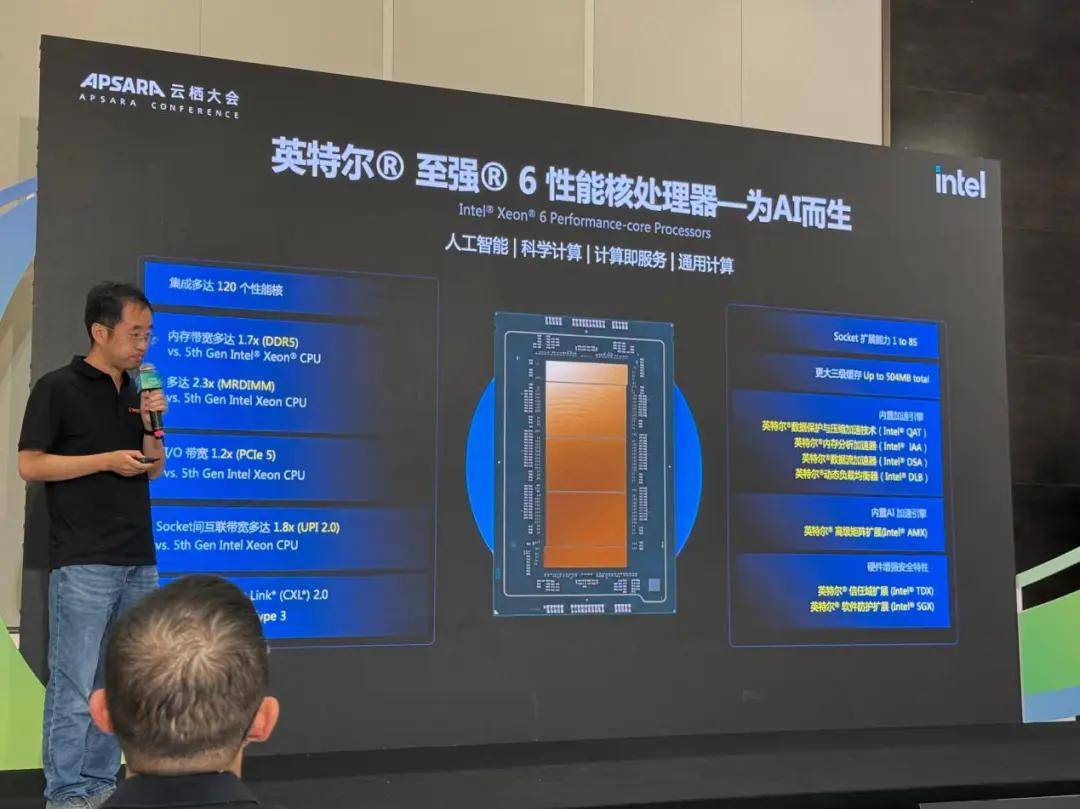
2025年,英特尔完善了采用性能核心设计的至强6产品组合;2026年发布的至强6+处理器(代号Clearwater Forest)基于Intel 18A制程,采用能效核设计,最高配备288核心,进一步把核心密度和每瓦性能推向新高,同期还发布了英特尔以太网E835产品连接方案。加上内置的QAT、DSA和IAA等加速器与SGX、TDX等安全技术,从第四代至强可扩展处理器到至强6、至强6+,英特尔目前已经形成一条面向智能体负载不断演进的产品线。
阿里云智能集团首席服务器架构师卓久也直言,英特尔不只是一家CPU公司,而是一家具备CPU、GPU、存储技术和软件能力的全栈公司,双方围绕CXL、QAT等技术的合作已经产生了“1+1>2”的效应。
下一代至强Diamond Rapids:为Agent时代重新设计的CPU
本次专场最硬核的部分是英特尔技术专家龚海峰对下一代至强处理器Diamond Rapids的架构解读。这也是继Hot Chips 2026之后,Diamond Rapids在国内舞台上最集中的一次技术详解。
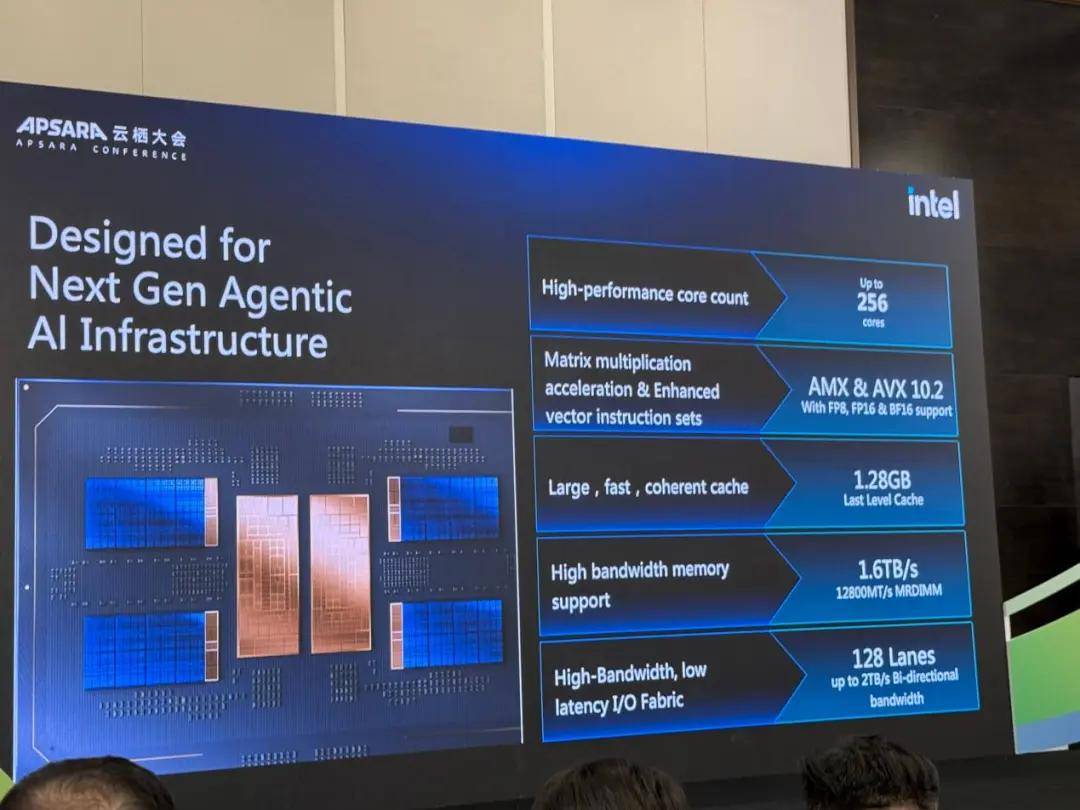
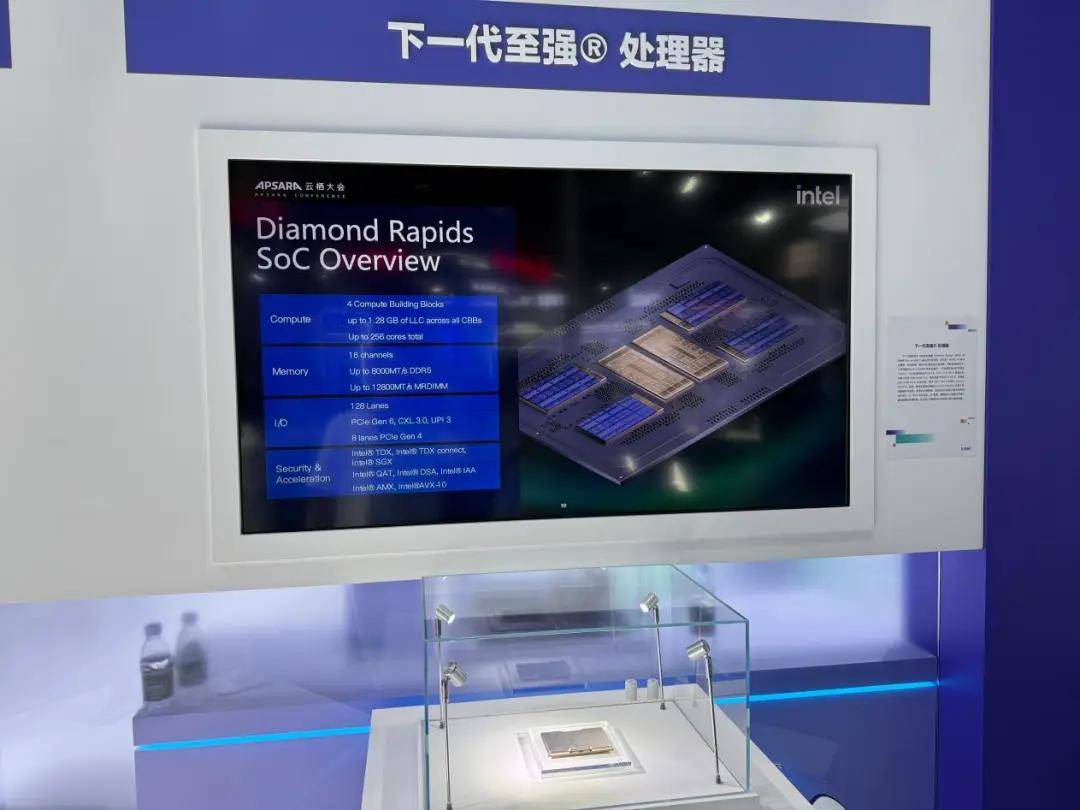
Diamond Rapids最高支持256个性能核心,配备增强的AMX和AVX 10.2指令集,支持FP8、FP16、BF16;末级缓存达到1.28GB——没错,CPU缓存正式进入GB时代;提供16个DDR5内存通道,支持最高12800 MRDIMM,内存带宽高达1.6TB/s;I/O方面则提供128条PCIe 6.0通道。这颗计划于2027年发布的CPU,从指标上看几乎是为Agentic负载“量身定制”。
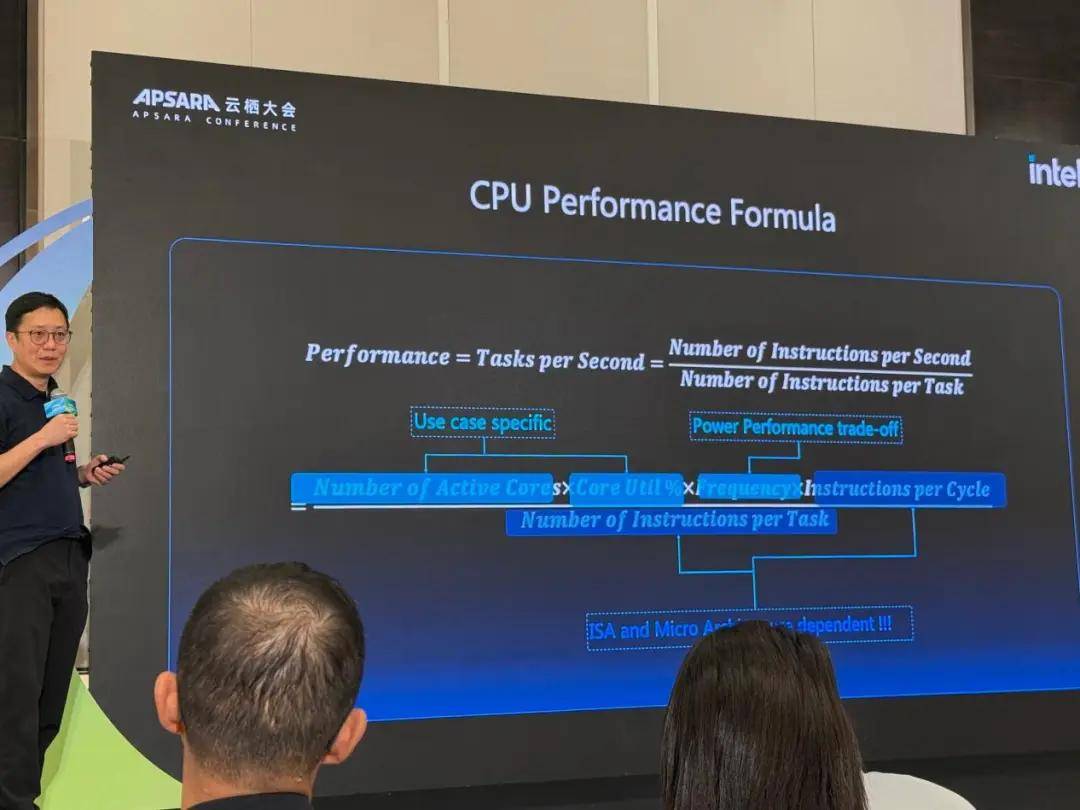
英特尔认为,评判Agent时代的CPU不能只看核心数量。于是龚海峰给出了一个简化的性能公式:单位时间内完成的任务数=参与任务的核心数×每核时间占比×时钟频率×IPC,再除以完成一个任务所需的指令数。这意味着评价一颗面向Agent的CPU,不能只看核心数量和频率,而要看它能承载多少智能体、每个智能体完成任务有多快。在这五个变量中,真正与CPU架构相关的优化抓手是提高IPC和减少完成任务所需的指令数。他总结为三句话:简化指令、加快执行、减少空转。而Diamond Rapids的设计处处体现着这一思路。
在指令集层面,Diamond Rapids全新的性能核支持APX指令集,这是一次对沿用多年的x86通用整数指令集的现代化扩展。最重要的变化有两个:一是通用寄存器数量直接翻倍,从16个增加到32个,让更多数据可以常驻寄存器,减少内存与寄存器之间的搬运;二是引入New Data Destination(NDD)特性,以往的两操作数指令如A=A+B执行后A的原值被覆盖,若后续还需使用就必须事先保存,而NDD允许结果写入独立的目标寄存器(相当于C=A+B),从而减少不必要的数据复制。此外,Diamond Rapids的堆栈操作、条件比较、条件加载和存储也都做了优化。
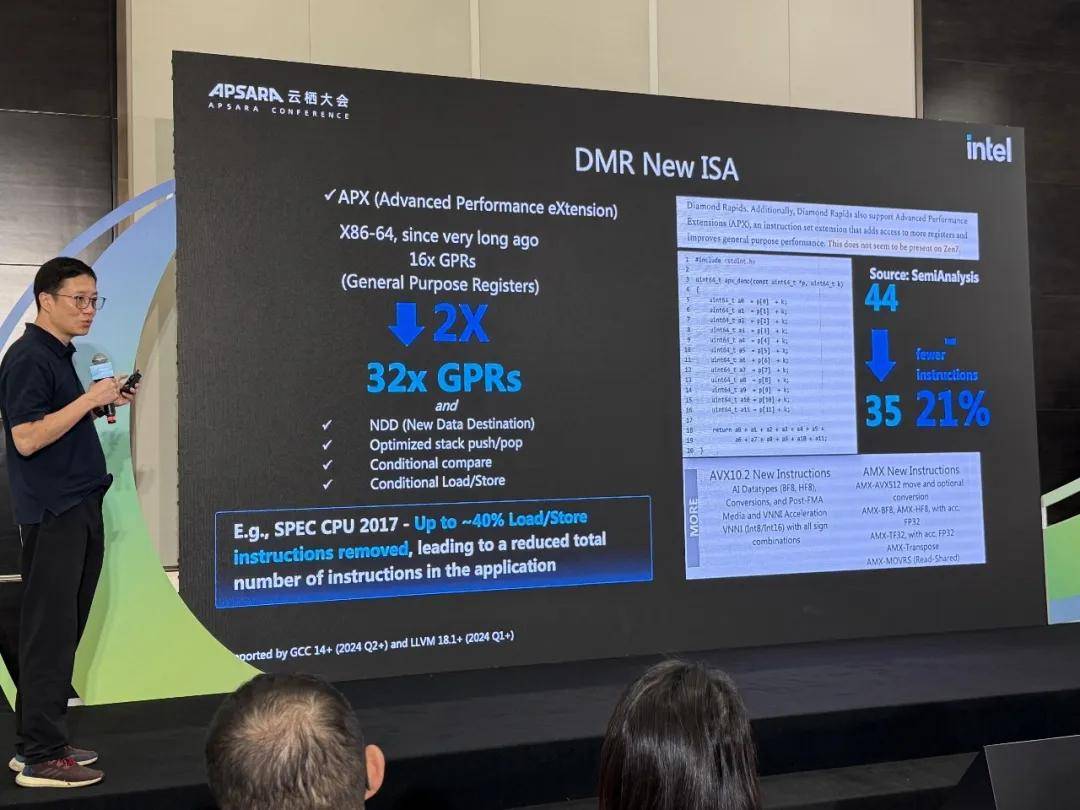
龚海峰给出的实测成绩显示,在SPEC CPU 2017中,使用支持APX的编译器重新编译后,整个程序代码中的Load/Store数量减少了40%——这不仅带来性能提升,也减轻了内存带宽的压力。
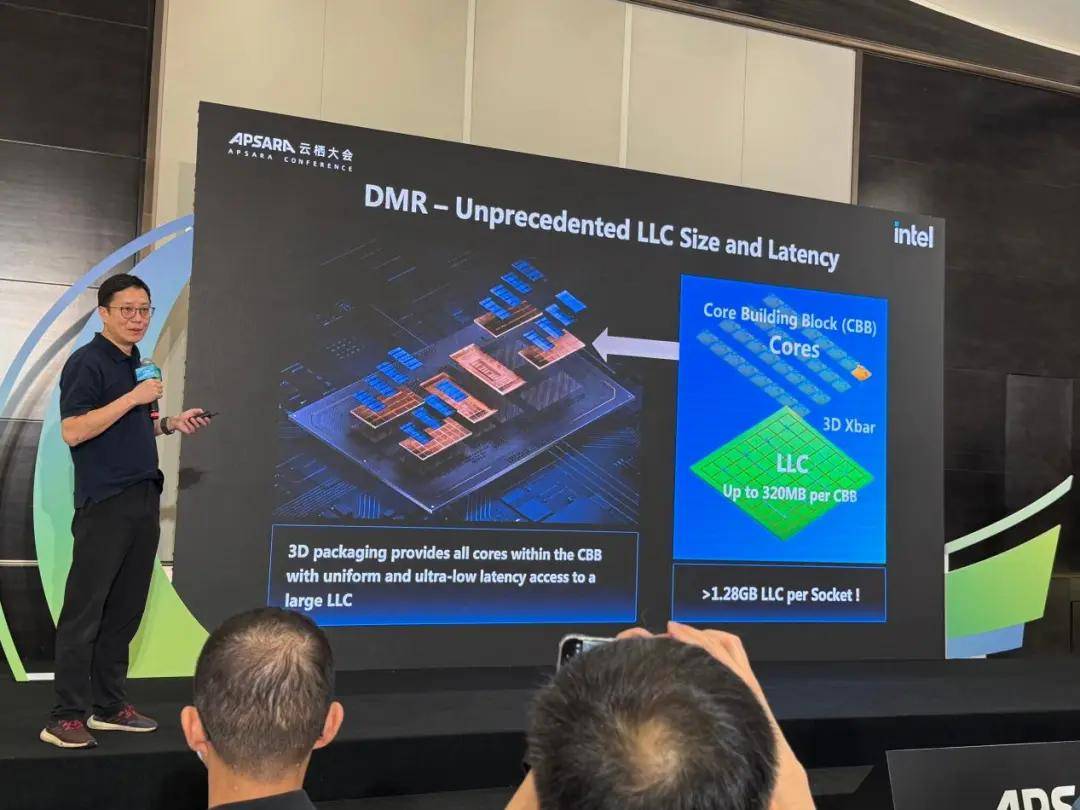
Diamond Rapids采用3D封装设计,缓存被置于CBB模块的底层、计算核心位居“楼上”,核心通过垂直连接访问下方的缓存——访问路径由此大幅缩短。在这一设计中,整个SoC可提供最高1.28GB的三级缓存,每个CBB模块中的核心共享320MB缓存。
封装之上是英特尔首次采用的全新Fan-out Fabric架构。两颗Fabric Hub芯片位于中心,提供内存和I/O接口;周围围绕着承载计算核心与缓存的CBB模块,CBB与Fabric Hub之间通过Chiplet UCIE接口全连接,每个Fabric Hub连接4个CBB,每个CBB连接2个Fabric Hub。这种设计让不同CBB上的核心都能通过均衡的路径访问内存通道和I/O资源,提供高带宽、低时延,同时显著降低软件层面复杂的NUMA划分和适配的负担。对追求部署敏捷性的Agent业务而言,这种设计非常实际。
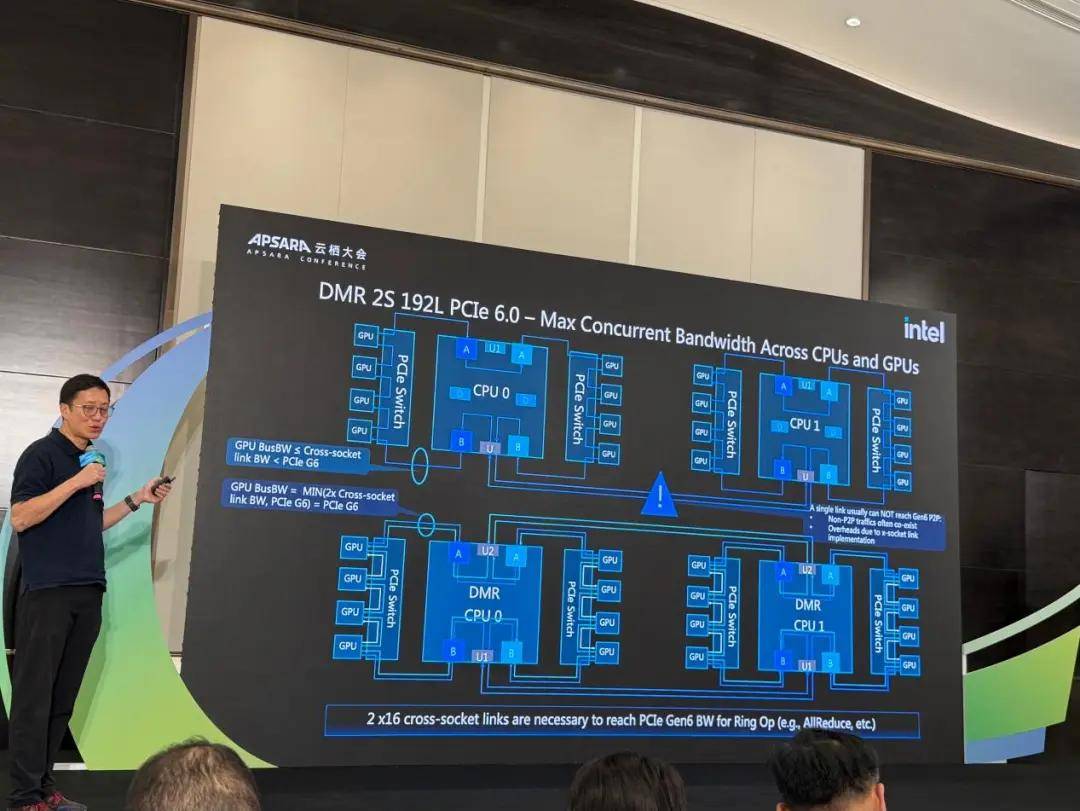
另外,在GPU服务器的一机八卡场景里,有一个容易被忽略的问题,即使GPU与CPU之间都有完整的×16连接,两颗CPU之间的跨插槽带宽也可能成为瓶颈——当GPU之间需要All-to-All集合通信时,部分数据需跨插槽传输,如果两个插槽之间只有一条×16链路,就会形成拥堵。针对这一点,Diamond Rapids的128条PCIe 6.0通道带来了很大的灵活性,插槽之间最多可以配置四条×16链路,也可以按需选择两条或三条。
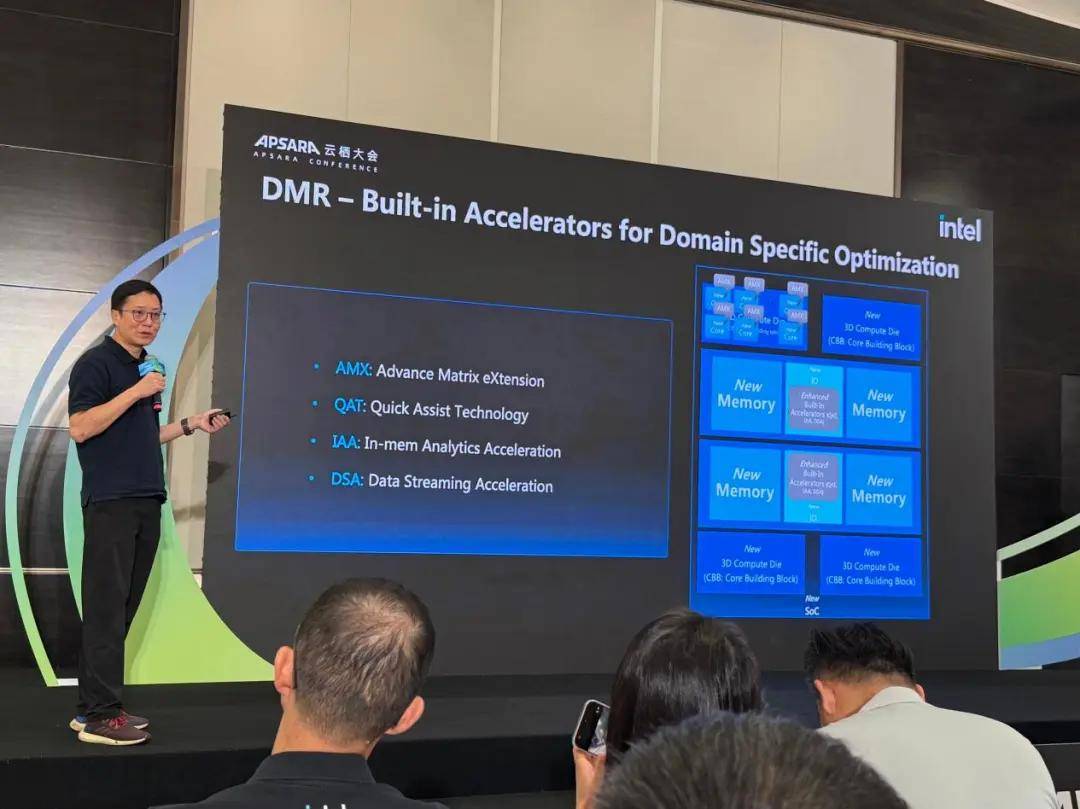
除此以外,像英特尔AMX、QAT、IAA和DSA这些深受云计算客户欢迎的经典加速器也在Diamond Rapids上得到保留并做了版本升级。多模态数据预处理、KV Cache压缩/解压缩、Agent沙箱加载与快照等场景都可以继续卸载到这些专用加速器上,而且在Diamond Rapids上完成得更快。
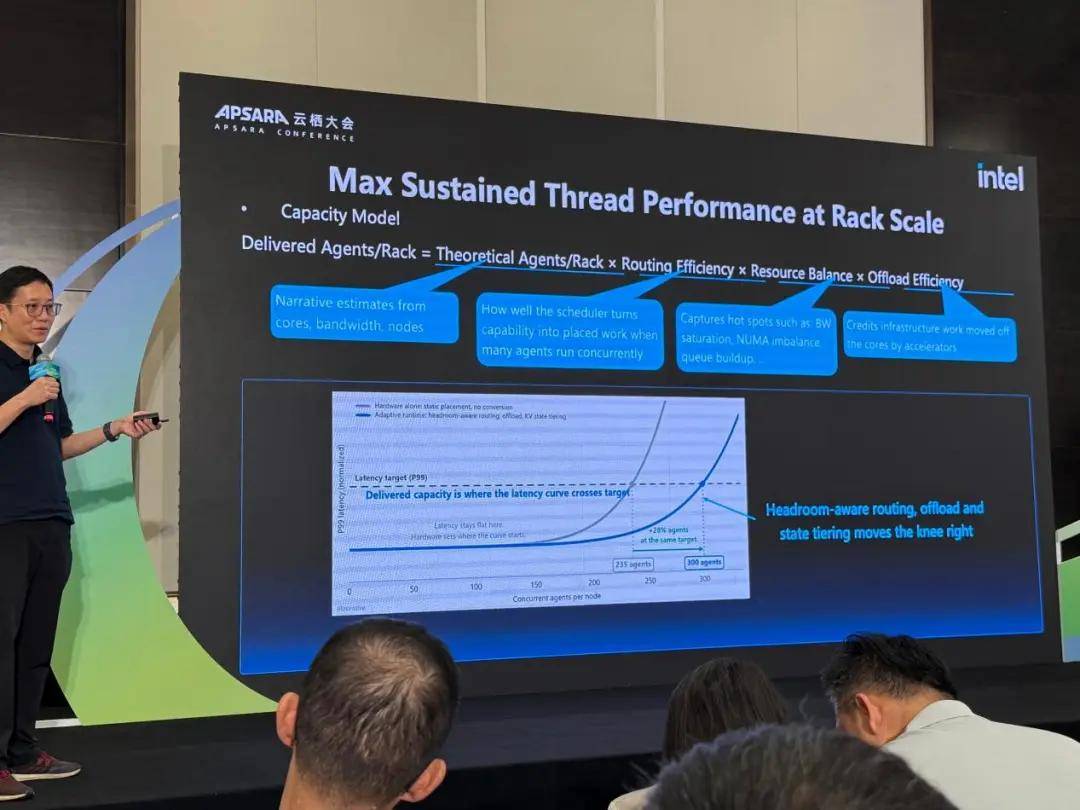
龚海峰还提出了一个对业务方非常实用的评估框架,即评估一台服务器或一个机柜能稳定承载多少智能体,不能只看硬件硬指标,还要看三个转换系数——Routing Efficiency、Resource Balance和Offload Efficiency。在他展示的图表中,横轴为承载智能体数,纵轴为P99时延的曲线,真正有意义的是满足P99时延目标的那一段。要在满足时延要求的前提下承载更多智能体,就需要Headroom-aware Routing(按剩余资源余量分配任务)与计算卸载的结合,而Diamond Rapids为此提供了丰富的性能遥测能力和硬件加速能力,能帮助客户在同一台机器上部署更多智能体,又不突破SLA。
英特尔下一代推理GPU Crescent Island:为Agent长上下文而生
如果说Diamond Rapids是此次活动的“主角”,那么代号Crescent Island的下一代数据中心GPU就是英特尔埋下的“伏笔”。Crescent Island专注推理,一切围绕“Token经济性”展开。它采用Xe3P微架构,整张卡由4个计算切片构成,每个切片8个Xe核心,合计32个Xe3P核心、256个向量引擎、256个第三代XMX矩阵引擎。XMX脉动阵列深度从上一代的4加深到16,每核通用寄存器堆翻倍至1MB,L1/SLM增加到512KB,并配备32MB统一L2缓存——这是一套围绕吞吐效率优化的设计,传统的3D渲染与光线追踪模块被移除。
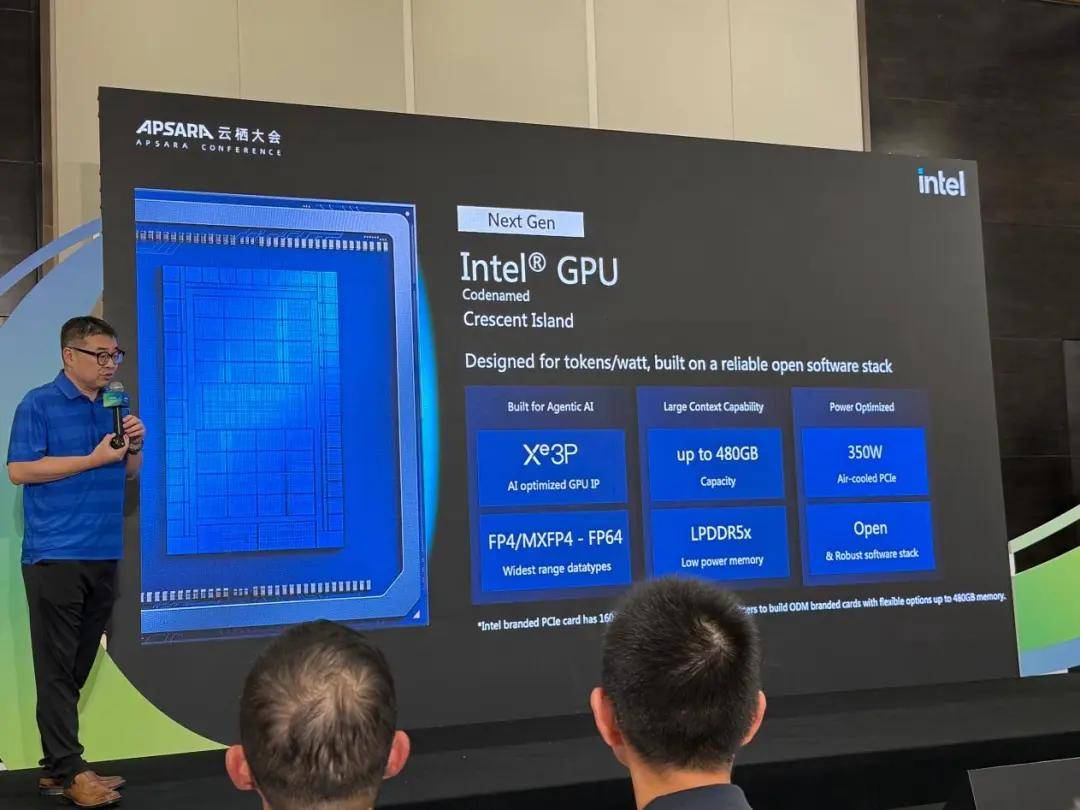
Crescent Island采用LPDDR5X显存,最高配备480GB显存;整卡典型功耗仅350W,可直接装在传统4U/5U服务器中。在精度支持上,Crescent Island覆盖FP4、MXFP4到FP64的全档位数据类型,可满足不同推理和HPC负载。Crescent Island预计在2027年正式量产。
与阿里云的合作:从九代实例到块存储、Agentic Browser
作为长期合作伙伴,英特尔与阿里云正基于至强处理器,围绕云实例性能优化、AI存储平台加速、Agentic Browser创新应用以及千问展开合作,共同探索面向智能体时代的新一代基础设施架构。
搭载英特尔至强6处理器的阿里云第九代企业级ECS实例g9i,覆盖智能体全栈算力需求。针对智能体业务形态多变的特点,g9i实现了按智能体真实工作负载形态精准供给算力,打造了涵盖专有硬件AI加速、QAT硬件加速、数据全路径持久化、安全可靠的虾笼、出色的弹性能力和稳定性优化在内的6大技术能力。
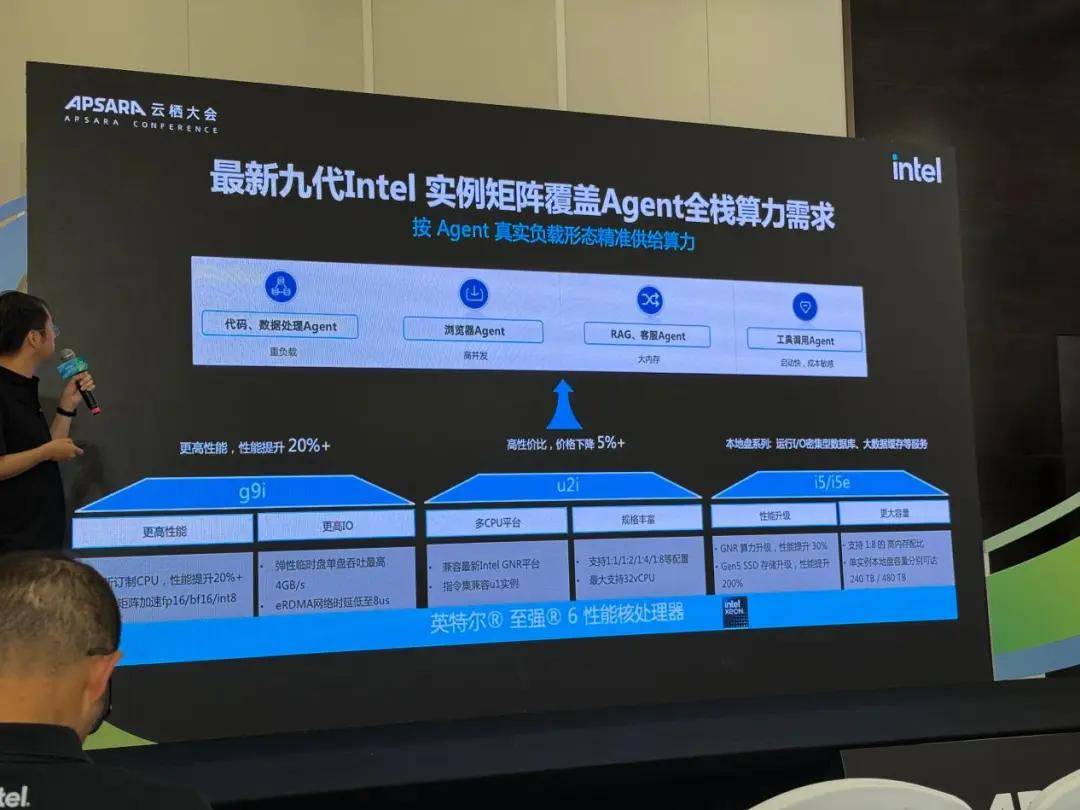
英特尔至强6处理器从芯片底层激活了g9i的效能,提供了高密度的核心数、出色的单核性能与内存带宽,同时又在性能与能效曲线上找到了平衡点,成为承载AI智能体复杂工作负载的可靠支撑,帮助g9i性能较上代提升最高达20%,弹性临时盘单盘吞吐最高4GB/s,为更多的行业与客户提供了更强劲、更稳定的云计算服务。
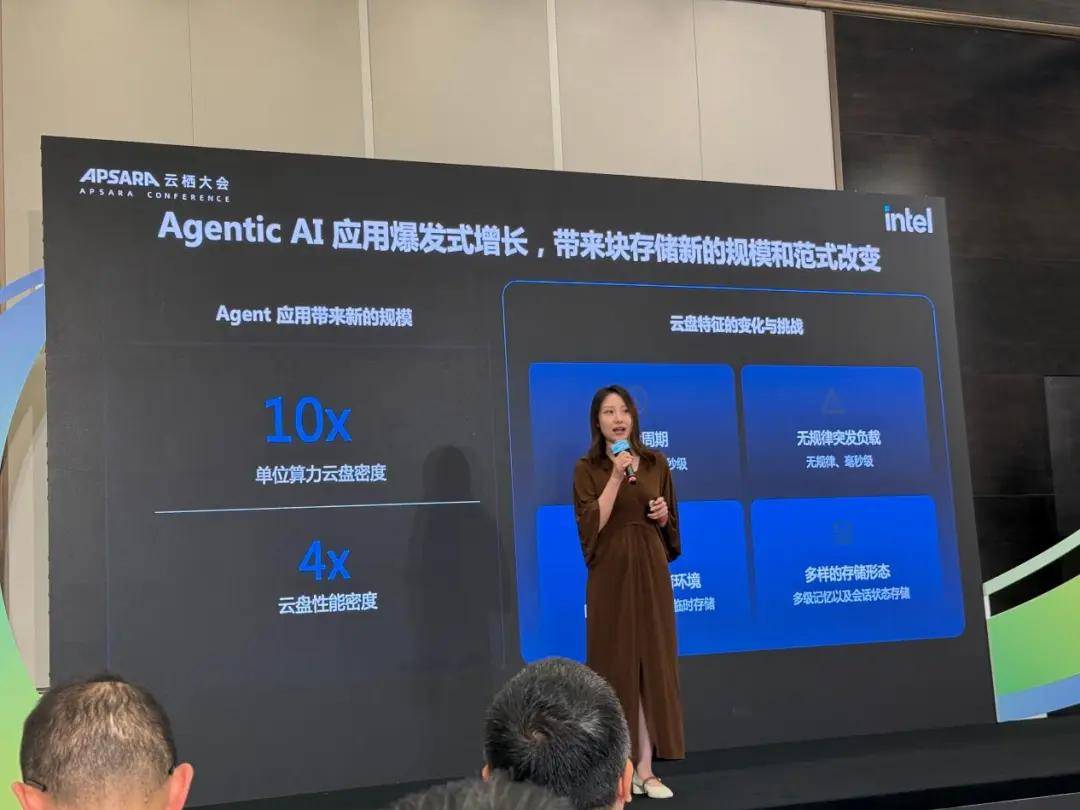
在块存储方面,阿里云高级技术专家彭艺蕾分享了磐久第九代存储服务器(基于至强6,代号GNR)的软硬协同实践。面对百万级实例创建、百毫秒级同步唤醒的高密度管控场景,阿里云利用Turbo Boost、CAT缓存分配和NUMA感知调度啃下了多核锁竞争和上下文切换两块硬骨头。数据面上,DDIO让设备数据直达LLC缓存,DSA卸载数据校验与搬移,QAT接管带校验的数据压缩链路。最直观的结果是压缩带宽提升400%,参与压缩的CPU核数降低75%,单线程能力整体提升40%以上——这一整套优化已在阿里云存储生产线大规模铺开。
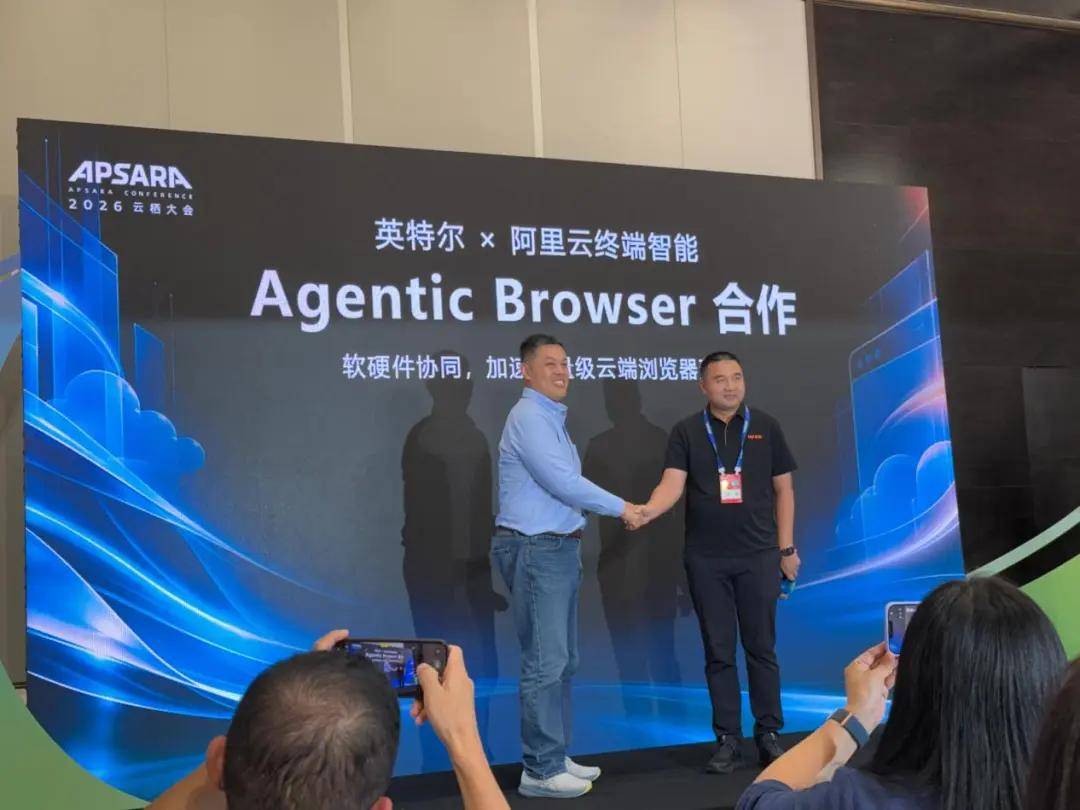
英特尔还和阿里云展开了在Agentic Browser层面的合作。在云栖大会现场,英特尔数据中心集团副总裁、中国区总经理陈葆立和阿里云智能集团研发副总裁、终端智能计算事业部负责人张献涛出席Agentic Browser合作仪式。阿里云终端智能与英特尔围绕浏览器引擎优化、硬件加速及云端高密度部署展开合作,共同推动Agentic Browser在智能体场景中的规模化应用。
正如阿里云高级产品专家蒋佳忆给出的判断:“新一批上网的用户不是人,而是Agent。”基于此,阿里云与英特尔基于官方Chromium主干对Blink、V8引擎做了面向Agent场景的裁减调优,结合AVX-512指令集及IAA、QAT硬件加速,使浏览器实例内存开销最多降低约30%;配合Agent与RPA双引擎和Workflow自动沉淀——任务跑通一次就沉淀为可回放脚本,重复任务不再让大模型重新规划,以一次小红书发帖为例,Workflow回放的消耗可以比通用办公Agent低两个数量级。如今这套方案支持单Agent并行拉起数百个轻量浏览器实例。
数据库侧同样在打配合。PolarDB技术专家陈浩介绍了面向Agentic Workload的四层软硬协同架构:MCP统一管控Agent数据访问边界,数据库分支功能允许Agent在隔离环境试错,外置KV Cache把GPU显存压力卸载到分布式内存池——线上实测TTFT降低61%,端到端时延降低53%,AMX加速的向量抽取较原方案性能提升2.5倍。
云端之外,英特尔与阿里的合作还延伸到端侧。阿里巴巴千问事业部AI Infra技术专家户瑞林带来了端侧推理的实战分享。
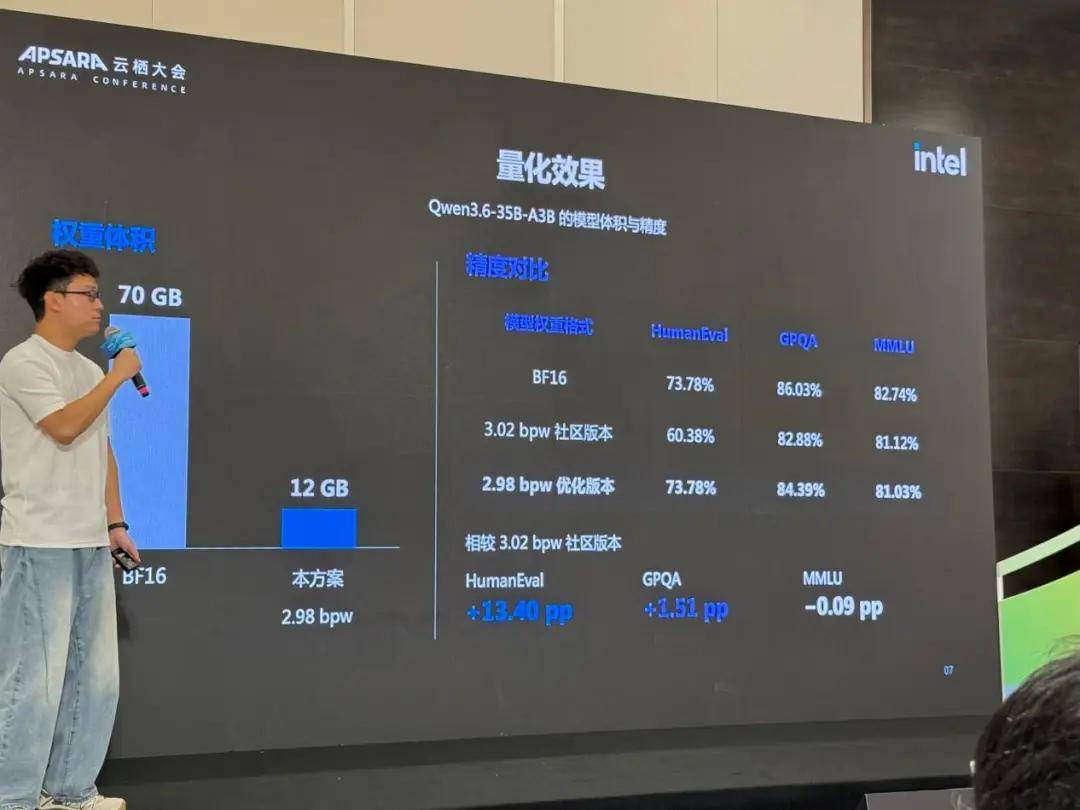
户瑞林团队通过混合精度低比特量化,把35B-A3B模型从70GB的原始权重压缩到约12GB的体积,同时精度较BF16损失不到1%;再通过分层卸载与预测性预取,把模型按需分布在显存、内存和SSD上,专家命中率显著提升;配合前缀缓存与DAUS类投机解码,最终在一颗英特尔酷睿Ultra X7 358H处理器上跑出了约50 Token/s的输出速度,已经足以支撑PPT、Excel等日常办公Agent的流畅交互。户瑞林指出端侧推理的三重价值,即隐私保护、离线可用以及成本可控。
另外,阿里云在云栖大会上宣布正式开源的Qwen-Image 2.1也在英特尔平台上获得Day 0支持——在OpenVINO工具套件的加持下,它可以同时运行于英特尔锐炫Pro B70独立显卡以及英特尔酷睿Ultra 3系列处理器的集成显卡,把专业级图像生成能力带到AI PC与边缘设备上。
写在最后
智能体AI时代,至强处理器凭什么重回C位?答案其实不复杂。当AI从“一次性问答”变为“长时间、多环节和高并发地持续干活”,任务的编排、数据的搬运、记忆的管理、沙箱的拉起、成本的控制以及安全的保障,每一项都是CPU的主场。尽管GPU依然是算力之王,但智能体时代真正考验的是整个系统的吞吐、时延、经济性与可靠性,这恰恰是英特尔至强产品体系几十年来的积累所在。
当然,现有的至强产品并非“Agentic原生”设计,它是在以架构延续性和丰富的内核加速器拥抱一个快速发展的负载形态。真正的答卷,可能还得看2027年的Diamond Rapids。不过无论如何,从2026年云栖大会的主角以及英特尔与阿里云开展的各项合作进展来看,当前智能体AI行业的发展趋势已经非常清晰——在这样的背景下,CPU的下一站不再只是配角和枢纽,而是智能体时代的超级中枢。而在中枢之外,英特尔的GPU产品线也正在悄悄围拢。