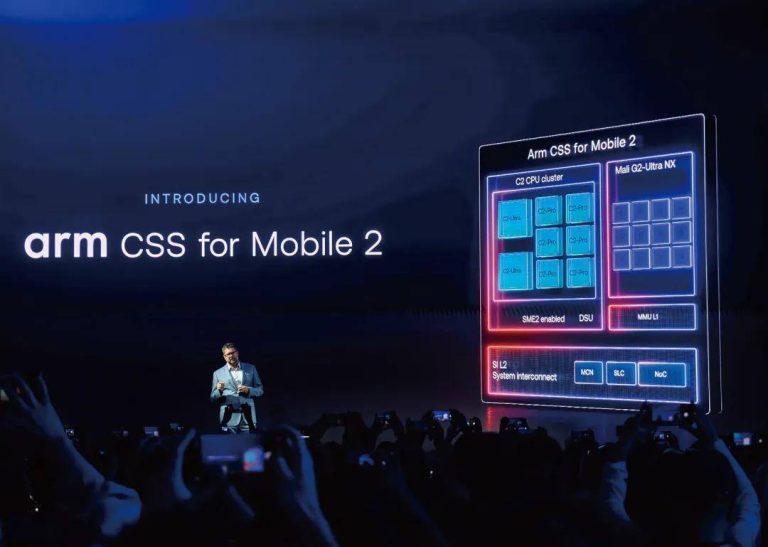
在9月2日的Arm Tech Day媒体沟通活动以及9月8日的Arm Everywhere会上,本刊采访到了Arm边缘AI执行副总裁Chris Bergey、Arm边缘AI智能终端计算副总裁James McNiven、Arm边缘AI高级产品经理Deyan Lazarov以及Arm边缘AI CPU产品管理总监Daniel Lu等多位Arm公司的高管。下面就请大家一起来了解此次Arm新品的更多情报,以及Arm如何看待边缘AI的发展态势。

Arm边缘AI高级产品经理Deyan Lazarov
Arm边缘AI CPU产品管理总监Daniel Lu
提问:进入智能体时代,CPU在底层承担了更多的任务编排职责。那计算竞争的中心是否重新回到了CPU性能和内存系统?如果一台设备配备了非常强的第三方NPU,但CPU性能相对较弱,其运行智能体任务最大的瓶颈会是什么?
Daniel Lu:回顾过去十年行业对不同工作负载的侧重,其实折射出每一代计算需求的演进。如果简单地认为明年CPU会变得更加重要,并不准确。行业始终在针对不同设备和特定应用场景,寻找最合适的算力平衡点。无论是数据中心还是受新型工作负载驱动的端侧设备,都面临类似的问题和挑战。未来几年,这种平衡关系还将持续演进。
关于第二个问题,答案很大程度上取决于具体应用场景以及面向的目标工作负载。比如要求快速唤醒响应的低功耗设备,受整机功耗、预算限制,很难集成超大规格的GPU或NPU。因此,在不同类型的设备中,CPU、GPU和NPU的配比会呈现很大的差异。以云计算为例,五年前,业内曾普遍讨论过“一个CPU搭配八个GPU”的配置模式,但如今这一比例已经发生了明显变化。因此可以预见,未来五年,随着新型应用场景的不断涌现,CPU、GPU与NPU之间的配置关系很可能还会继续演变。
提问:当前CPU与NPU之间的任务分工,是交由各家SoC厂商自行决定,还是Arm会构建一套统一调度层,负责不同任务的分配工作?
Daniel Lu:从系统层面来看,某一项工作负载最终由CPU、GPU还是NPU运行,通常由系统厂商通过软件进行调度和控制。如果工作负载最终运行在CPU上,我们则会为合作伙伴提供相应的工具支持,帮助他们针对该工作负载充分优化CPU性能。
▲Arm边缘AI执行副总裁Chris Bergey(左)与Arm边缘AI智能终端计算副总裁James McNiven(右)
提问:Arm为什么会选择将神经网络加速器放在GPU里?
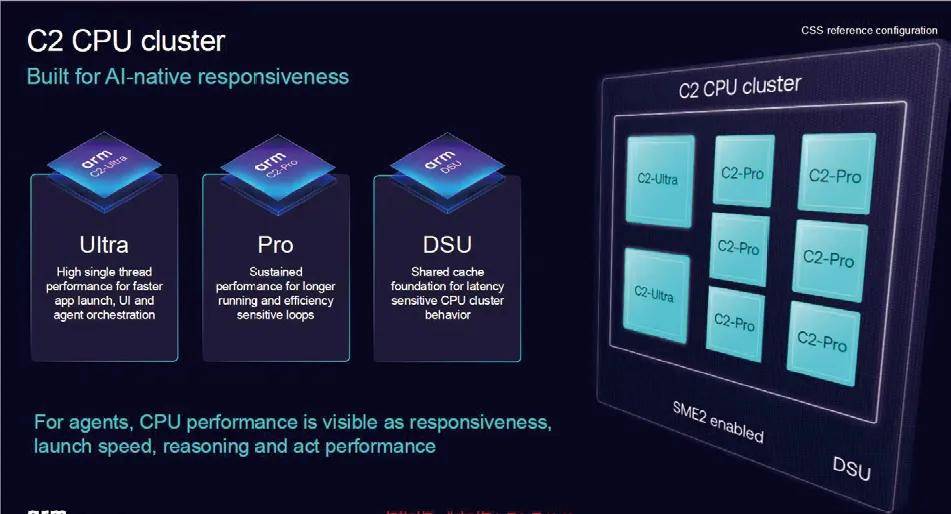
James McNiven:简而言之,我们认为在每一种计算引擎中都应具备相应的AI加速能力,让各类工作负载都能够在最适合的计算单元上高效运行。异构计算正是满足各类计算需求的最佳方式。不同的应用场景和计算强度,需要由不同类型的计算引擎来承担。因此,我们在GPU中集成了神经网络加速器,专门用于加速神经图形相关工作负载,并针对这类任务进行了高度优化。与此同时,我们在最新的C2 CPU集群中配置了最多两个SME2单元,能够基于CPU指令集对AI工作负载进行加速,从而提供更快速的响应能力和更低的延迟。此外,我们的芯片合作伙伴通常也会集成专用NPU,以加速其自身特定的AI应用和工作负载。
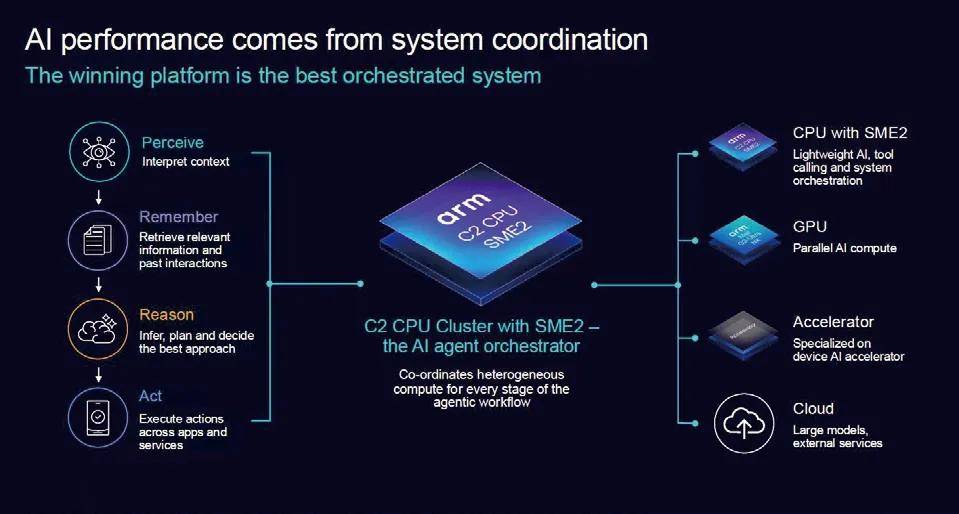
另外,我想强调一点,将SME2部署在CPU集群中,能够提供极低延迟和快速响应能力,同时还能充分利用CPU已有的安全模型与安全机制。而将神经网络加速器集成在GPU内部,则能够共享执行引擎的内存和缓存资源,例如L1和L2缓存,因此能够以更高效率处理AI图形相关工作负载,并实现更快的响应速度。
这种设计带来的好处是,不仅能够获得最佳性能和能效表现,还能够让AI加速功能与图形渲染管线紧密协同,与其他工作负载进行统一调度和并行处理,从而发挥整个系统的最佳效率。
提问:相较于传统NPU这种独立的原生AI计算划分方式,对于SoC算力利用会有什么区别?
Chris Bergey:两者之间存在不少差异。SME2最独特的一点在于,它的编程方式和CPU保持一致:开发者无需采用独立的编程模型,而是可以沿用熟悉的CPU编程方式,通过指令直接调用SME2的矩阵计算能力。正因如此,SME2能够实现极低的延迟,同时也更易于开发和编程。
去年我们介绍了Arm Kleidi软件库,开发者将其集成到AI框架,或者使用像ExecuTorch这样的抽象化框架时,底层软件会自动完成适配。如果硬件配备了SME2,它就能够自动调用这一能力;如果硬件不支持,则不会调用。
与之类似,神经网络加速器通过基于Vulkan的GPU工作流进行编程。相比之下,NPU通常作为独立加速器进行调度,因此采用的是不同的编程模式。事实上,来自不同供应商甚至不同产品形态的加速器,其编程模型也各不相同,具有相当的独特性。这也正是开发者需要重点考量的地方,即根据自身工作负载的运行需求,选择合适的技术路径。
提问:如果NPU方案需要针对每一颗NPU芯片单独完成适配工作,而CPU通用性相对更强。那么开发者是否会缩减在NPU侧的开发投入?
Daniel Lu:就目前的设备生态而言,我们看到第一方应用对NPU的利用相对更加充分,而更广泛的第三方应用生态对NPU的使用程度还没有达到同样的水平。对于第三方开发者来说,选择面向CPU开发的一个重要优势在于能够获得更好的跨平台、跨厂商兼容性。当然,厂商也可以根据NPU的特定优势投入相应的时间和研发资源,但最终是否这样做,还是取决于他们自身的业务判断和产品策略。
提问:智能体需要持续调用工具并保持运行状态,而智能手机受电池功耗、内存资源约束比较大。请问对于Arm平台而言,如何解决AI智能体持续运行所带来的内存和功耗难题?
James McNiven:这取决于我们如何定义“持续运行”这个概念。手机本身一直向网络发送信号,持续在后台运行各类任务。所以,全时段高强度占用整个系统,与按周期进行调度,这两者之间是有区别的。目前许多OEM厂商和智能体供应商也还在摸索这部分的实现方案。但实现高效持续运行的智能体工作负载并非不可能,关键在于任务的运行强度。部分智能体可以周期性触发运行,但并不需要微秒级不间断持续工作。
Chris Bergey:另外我想补充两点。第一,我们在玩游戏时,通常同时活跃的线程数量是3~4个,这样的状态可能持续一个小时甚至更久,这说明通过智能调度能够实现很多可能性。第二是可以利用充电场景。当您晚上给手机充电时,设备可以进行大量的KV缓存优化和上下文预处理等工作。因此,我们可以将其理解为两种不同的运行模式:电池供电模式以及充电供电模式。在充电状态下执行Token生成这类高负载任务,就能让设备在移动使用阶段拥有更高的运行效率。
提问:往年的技术分享会,Arm主要是讲解新一代GPU的硬件规格,但今年还专门介绍了软件栈和生态。请问这个变化的主要原因是什么?此外,Arm的AI原生GPU和CPU,除了图形以外,是否也在探索帮助提升智能体这类应用的表现?
Deyan Lazarov:我们高度重视软件生态建设,核心目标是降低开发者使用门槛,让技术更易于上手。为此我们重点投入开发者已经在使用的工具链和开发环境。过去人们通常习惯把图形计算和通用计算看作两个独立的领域,而现在我们把这个范畴进一步扩展,将神经网络计算也纳入我们统一的计算体系之中。我们不希望把图形能力和AI能力相互割裂,二者需要深度融合,以此实现更高的整体开发效率。同时,我们也需要与整个生态系统紧密合作,确保技术方向符合行业需求,并不断吸收来自生态系统的反馈。
第二个问题的答案是肯定的,但具体还要视应用场景而定。GPU属于通用加速器,本身具备很高的易用性。只要神经网络采用合适的数据格式(比如INT8),便可以在GPU上运行,以获得出色的运行效果。即使网络并非完全采用这种数据格式,比如存在部分是浮点运算,我们的GPU依然可以处理。因此它是通用性强、适用范围很广的算力资源。未来更多应用场景的探索将由生态系统共同推动,而现阶段我们的核心重点仍聚焦在图形应用。
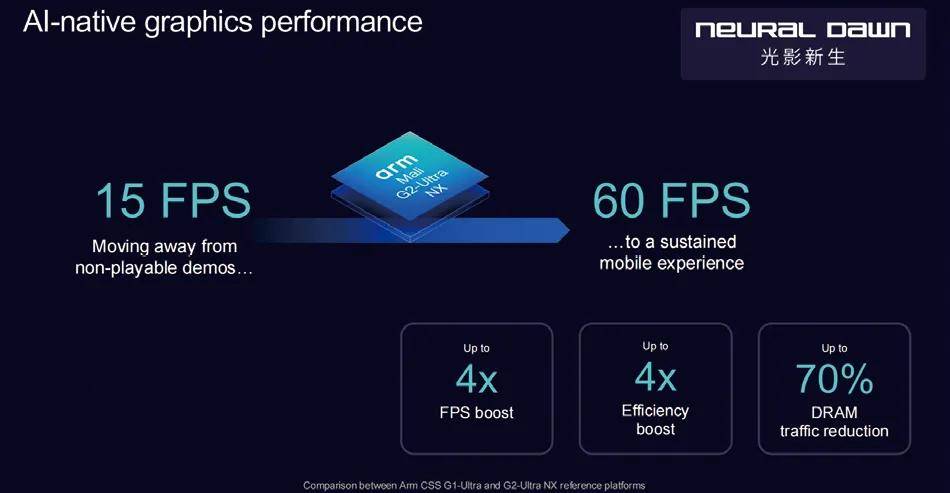
提问:近期NVIDIA面向桌面端的DLSS 5备受行业关注。Arm GPU搭载的神经网络技术包含神经超级采样与降噪NSSD和神经帧率提升(Neural Frame Rate Upscaling, NFRU)技术。Arm这套神经网络技术核心提升点体现在哪些方面?
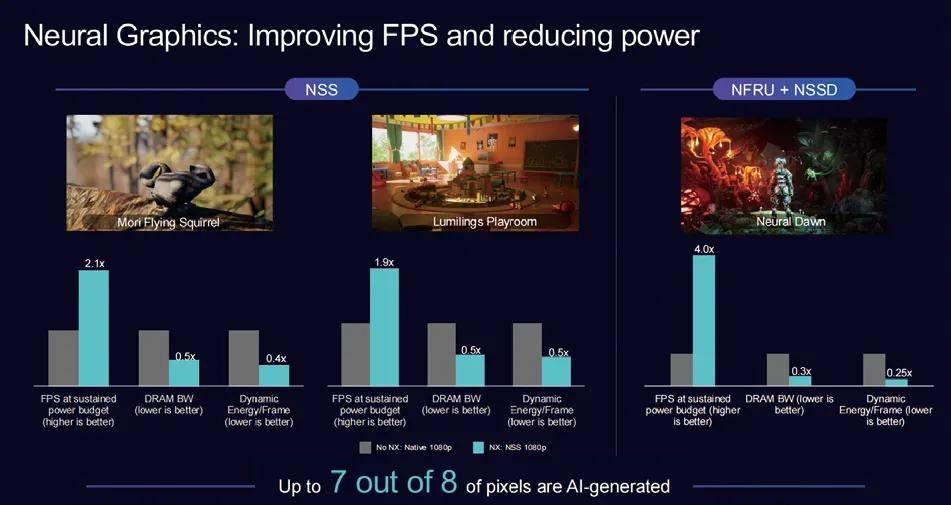
James McNiven:你提到的面向PC游戏的DLSS 5相关技术,包括超分、帧生成和降噪等,非常有代表性。我们在设计神经网络加速器时,一个核心思考就是如何在手机这样受功耗和散热限制的环境下,实现类似的用户体验和应用场景。以我们的神经超级采样NSS技术为例,该模型体量小巧且能效出色,我们的研发重点就在于保障其高效运行,并且能够持续稳定地输出对应性能。我认为二者最本质的差异在于,Arm的设计必须适配移动端的功耗约束,但底层要实现的应用场景是高度相似的。
另一个不同点在于我们的开放策略。我们的模型是开放的,手机厂商在完成相关验证后,可以根据自身产品需求进一步优化和定制。因为移动设备形态丰富,不同产品在性能、功耗和散热方面都有不同的要求,所以开放性非常重要。
当然,DLSS 4、DLSS 5每一代都带来了令人兴奋的新能力和新应用场景。我自己也很喜欢NVIDIA RTX显卡,但手机毕竟不同于PC。对于手机这样受限于功耗和散热的设备来说,可用资源比较有限,因此我们必须针对移动平台进行专门的架构设计和优化。
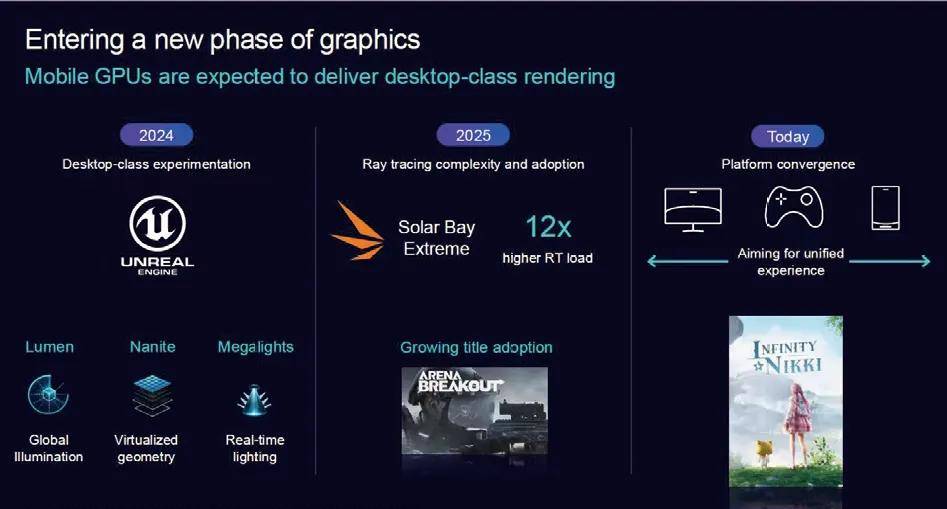
此外,我们也将看到诸如全局光照、辐射缓存等技术带来的新应用场景,这些都是我们正在布局的未来技术方向。但在当前阶段,我们更希望确保能够高效地实现高质量的图形效果,因此现阶段的重点仍聚焦于超分辨率和帧率提升,也就是实现大约帧率翻倍的效果。
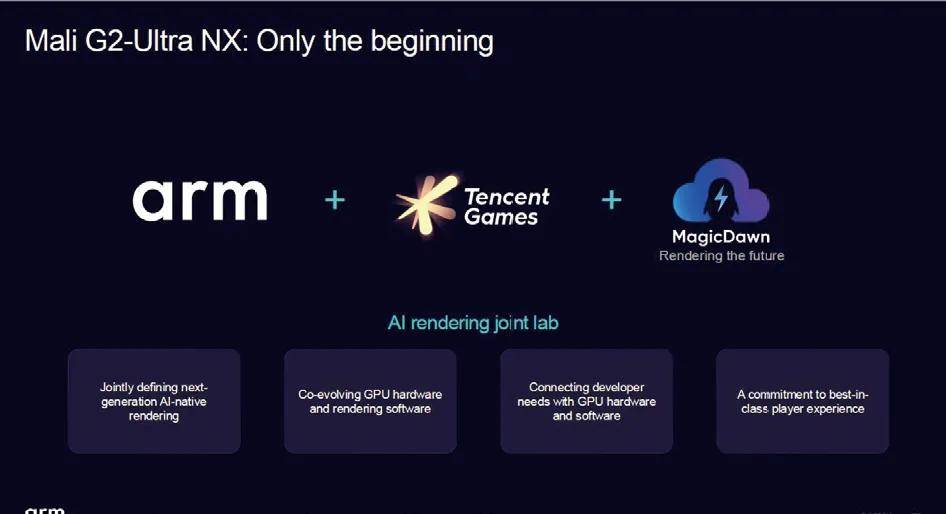
最后,我还想补充一点,在神经图形技术领域,我们近期宣布与腾讯游戏开展合作,共同探索神经动态全局光照(Neural Dynamic Global Illumination)等未来技术。这些都展示了神经图形技术未来的发展潜力。
提问:帧生成技术生成的帧数越多,是不是意味着延迟会明显增加,有没有专门针对降低延迟的技术?
Deyan Lazarov:目前版本的神经网络只支持在两个渲染帧之间生成一帧AI重建帧。但面向未来,我们已经规划了更丰富的路线图来扩展应用场景,这也是我们正在积极推进的方向。至于延迟,的确是一项关键考量。以30 fps场景为例,在实际应用中,单帧时间预算约为33 ms。开发者需要在这个时间窗口内既完成原始帧的渲染,同时完成AI生成帧的插入。这样在原本30 fps的时间预算内可以输出两帧画面,从而实现了60 fps的效果。
此外,开发者还需要配合使用帧步调(Frame Pacing)解决方案。因为实际运行过程中,帧与帧之间的时间间隔并不总是完全一致。虽然AI插值的延迟相对固定,但每一帧的实际渲染时间可能会有所波动。因此,需要借助Android平台或游戏引擎提供的帧步调解决方案,确保画面能够以稳定的节奏持续输出。
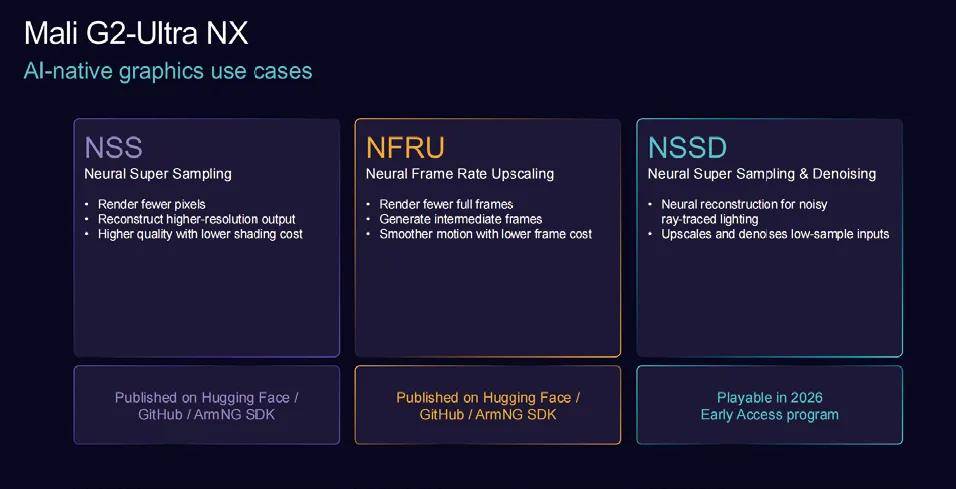
提问:我们注意到Mali G2-Ultra NX把神经网络加速器直接集成到了着色器核心内。传统着色器渲染资源与神经网络加速器资源将如何配比?
Deyan Lazarov:关于设计资源如何分配的问题,本质上与过去并没有太大区别。过去GPU仅具备图形计算能力,现在新增神经网络计算能力。从GPU的视角来看,运行神经网络加速器NX任务与运行计算着色器几乎没有区别。因此对开发者和GPU硬件本身而言,该层面并无实质性改变。在系统层面,我们引入了电源门控(Power Gating)机制。这意味着当AI加速器处于空闲状态时可以直接关闭,以避免不必要的功耗消耗。只有在真正需要时,它们才会启动运行。
另外,我们在设计过程中尽可能复用了现有架构,为了实现神经网络加速功能,并没有增加超出必要范围的额外硬件。因此,其芯片面积占用非常小,在晶粒实拍(Die Shot)中,甚至很难察觉到这部分新增电路。同时,这一设计还具备对称性与可扩展性。在产品说明中的附注部分可以看到,最小配置包含6个着色器核心(Shader Cores),合作伙伴可依据目标性能需求调整核心数量。
提问:如果未来越来越多的画面都交给AI来补全,那在接下来的几年里,GPU的设计思路会不会发生很大变化?
Deyan Lazarov:我想做一点澄清,我们使用的是卷积神经网络CNN,而不是Transformer网络,因此它并不像大语言模型那样通过生成内容来工作。我们的做法是从GPU渲染出的真实画面(Ground-Truth Data)出发,再利用卷积神经网络对图像进行超分辨率处理,并补全最终细节,从而生成插值帧或更高分辨率的画面。关键在于,这些网络是基于真实内容训练而成的。
AI在处理复杂内容时优势显著。例如对于拥有大量几何细节和复杂渲染需求的桌面级画面内容,AI能够发挥非常明显的作用。但并不是所有内容都这么复杂。对于简单的内容,本身渲染起来就不难,AI带来的增益相对有限。因此核心在于如何借助AI不断提升高复杂度内容的处理效率。
至于未来是否会把更多空间留给AI,我们认为,本次我们发布的Arm Mali G2-Ultra NX已经体现了这一方向。从行业发展趋势来看,我们相信AI增强图形(AI-Enhanced Graphics)将逐渐成为行业标配。不过,这并不意味着传统图形渲染会被取代。未来我们一方面会持续增强AI相关功能,另一方面也会不断推进传统图形渲染技术的演进。
提问:目前存储价格暴涨,未来两年很难改变。请问从CPU或GPU设计的角度,Arm是否有相关的技术规划或战略,来应对持续走高的存储成本压力?
Chris Bergey:移动产业当前确实正承受着来自多个方面的成本压力,不仅是存储价格,还包括晶圆成本。因此,我们正与合作伙伴共同努力,全力推进全链路优化,其中关键的一项就是推动AI模型向更小、更高效的方向演进,在有限的资源条件下实现更好的性能与能效。举例来说,我们已经与阿里巴巴通义千问合作,在SME2上实现了2-bit量化模型。由于模型规模非常小,因此能够在性能、成本和能效之间取得更好的平衡。
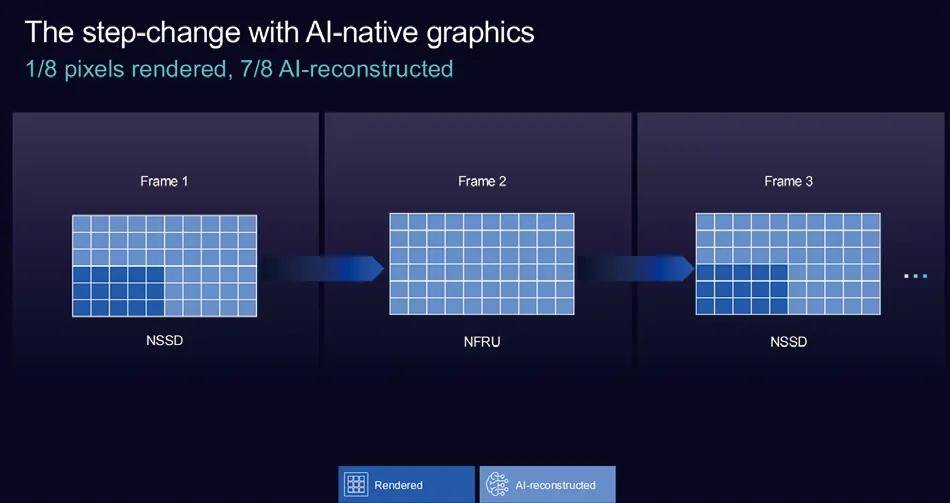
此外,通过让图形能力具备神经网络处理能力,我们可以减轻系统内其他承担同类任务加速器的压力,从而实现效率提升。因此,我们正尝试从多个不同维度来应对这一挑战,但这确实是一项艰巨的任务。
提问:小米已经宣布玄戒O3采用了Arm G2-Ultra NX。对于自研定制芯片厂商来说,他们拿到G2-Ultra NX之后可以开展哪些创新?
James McNiven:Arm G2-Ultra NX是以软IP的形式交付的,部分情况下我们也可提供硬宏(Hard Macro)实现方案。通常情况下,合作伙伴获取RTL交付后,可以根据自身产品需求决定具体配置,例如着色器核心与NX单元的数量配置。在此基础上,合作伙伴可以自行开展IP实现、配置及集成工作,有时甚至还会针对软件驱动进行进一步的优化。
因此,合作伙伴并不是直接使用一套固定配置,而是会根据自身SoC的设计目标进行定制化实现。正因如此,最终上市的不同SoC产品往往会呈现出不同的配置组合,例如采用不同数量的着色器核心、不同数量的NX单元、不同运行频率以及不同工艺节点。所有这些取舍和优化,最终都由我们的芯片合作伙伴自行决定并完成实现。