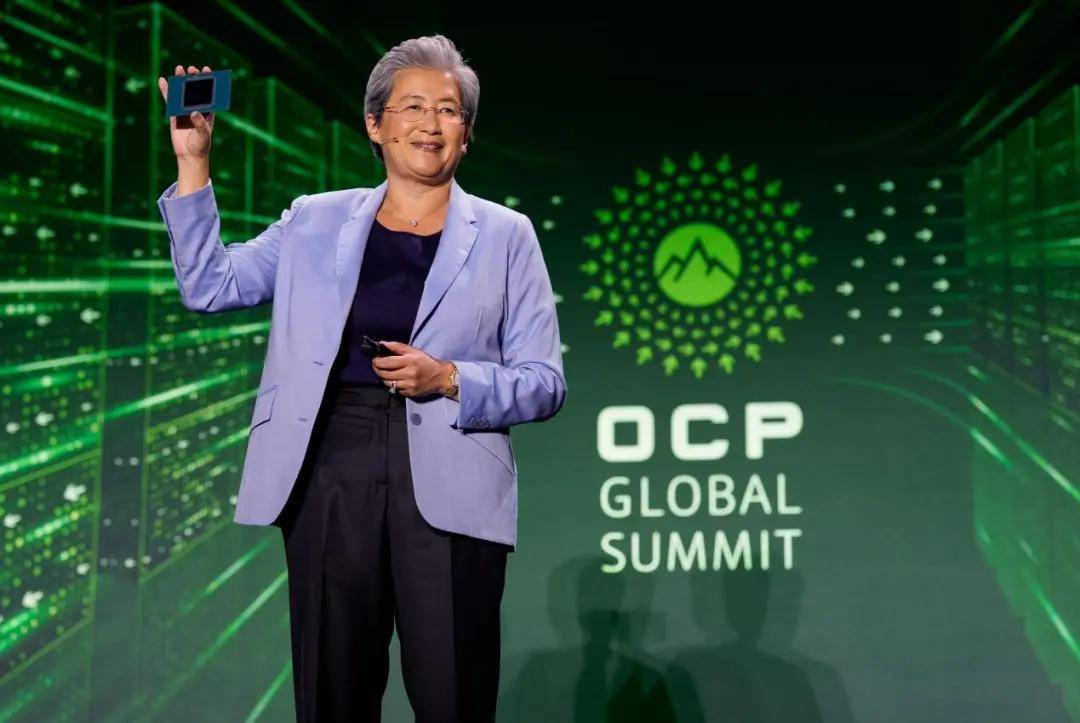
2026年10月12日,在美国加州圣何塞举行的开放计算项目全球峰会(Open Compute Project,OCP 2026)上,AMD董事长兼CEO苏姿丰(Lisa Su)发表了主题演讲,正式发布AMD Helion——一款专为智能体AI设计的开放式机架级参考设计。苏姿丰在演讲中系统阐述了AMD关于开放范式的长期战略理念,并表示AMD正通过开放标准重新定义智能体时代的计算基础设施。
AMD Helion机架蓝图详解
从命名来看,Helion与去年OCP峰会上首秀的Helios仅“一字之差”。但AMD Helion的设计逻辑与Helios却有着极为明显的差异。
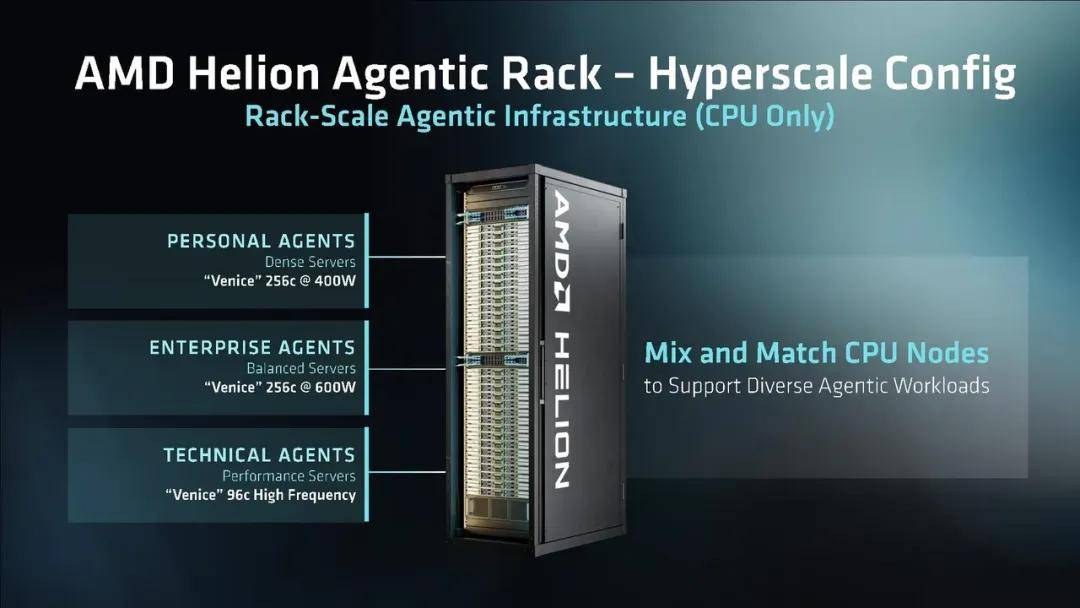
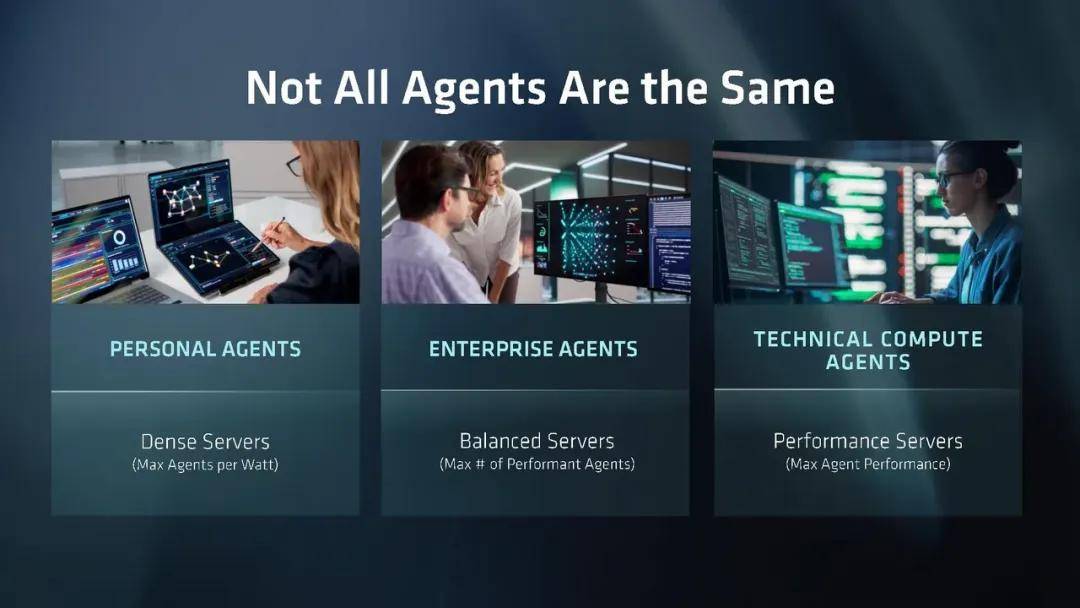
基于OCP ORv4规范构建的AMD Helion,提供两种基础配置。其中,纯CPU超大规模配置(CPU-only Rack Configuration)面向超大规模云厂商、新型云服务商和主权AI运营方,专为追求极致逻辑编排效率与大规模并发处理的超大规模数据中心而设计,以“每瓦智能体数量”最大化为优化目标。在遵守OCP整机规范的前提下,Helion单机架最多可容纳32768个CPU核心,相当于128颗旗舰级EPYC 9996 CPU。CPU刀片按智能体类型细分为三档:个人智能体对应256核@400W密集服务器,企业智能体对应256核@600W均衡服务器,技术计算智能体对应96核高性能服务器。
该方案将算力密度推向了全新的高度,能够为智能体提供近乎无瓶颈的并发任务调度环境,并通过高速数据中心互连协议与独立的深度学习推理集群协同工作,实现逻辑控制层与重度算力层的解耦与高效互通。
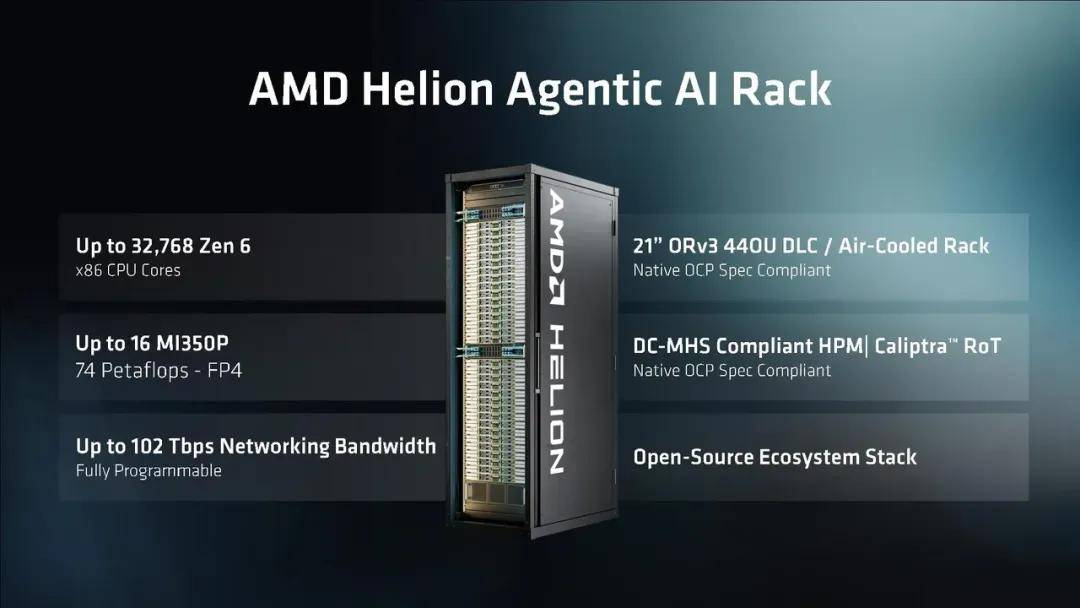
而CPU+GPU企业级一体化配置(All-in-One Rack Configuration)针对企业级数据中心对于开箱即用与综合性能的诉求,在同一机架内整合EPYC CPU与Instinct MI350P GPU,以及通用的数据与网络处理节点。它支持最多16块MI350P GPU,合计提供74 PFLOPS的FP4算力。
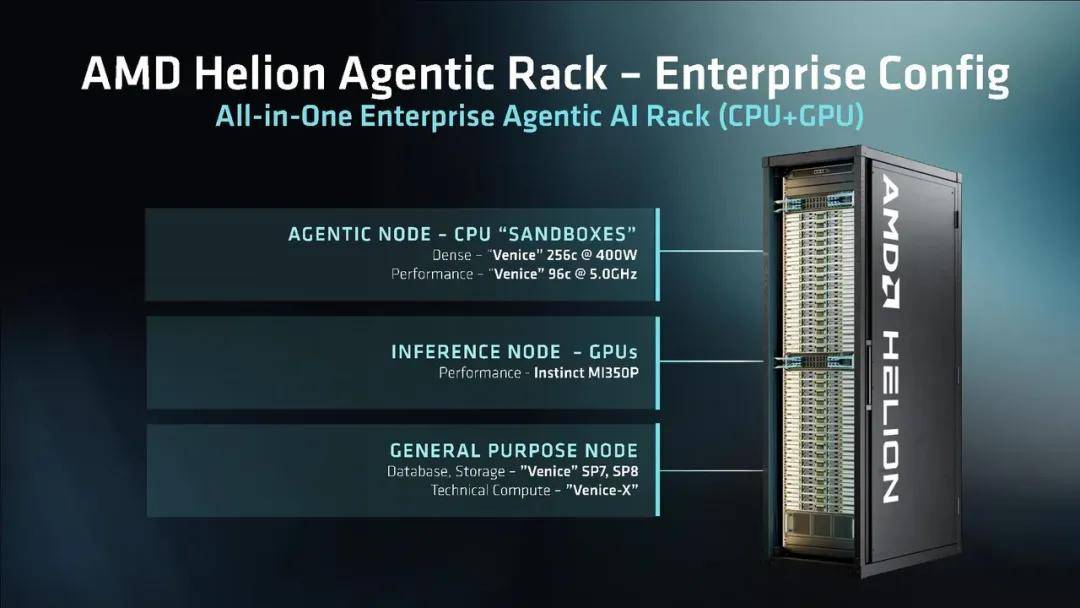
这种高度集成的拓扑架构,大幅缩短了逻辑处理与大模型推理之间的物理数据传输链路,使企业能够在统一的机架空间内完成从前端智能体感知、路由分发到后端大模型推理的全流程闭环。
除了硬件物理层的颠覆性创新,Helion机架蓝图的另一大核心优势体现在其内嵌的软件栈与算力调度能力上,最高提供102 Tbps可编程网络带宽,搭载开源软件栈。智能体在执行任务时,并不总是需要调用千亿级参数的大模型。对于许多简单的判断、提取与工具调用,小尺寸模型或特定专用模型往往效率更高、成本更低。苏姿丰博士特别强调基于应用场景进行算力精细化分发的重要性:“你不需要对每个问题都使用相同的计算资源。你需要能够将合适的模型和合适的计算资源路由到对应的应用场景中。这也是其中的一个关键部分,同时整体开放的环境也同样重要。”
为此,Helion集成了全新的Token router。作为智能体工作流中的调度层,它可以在前沿大模型、开源模型之间,智能匹配、分配智能体的调用请求。
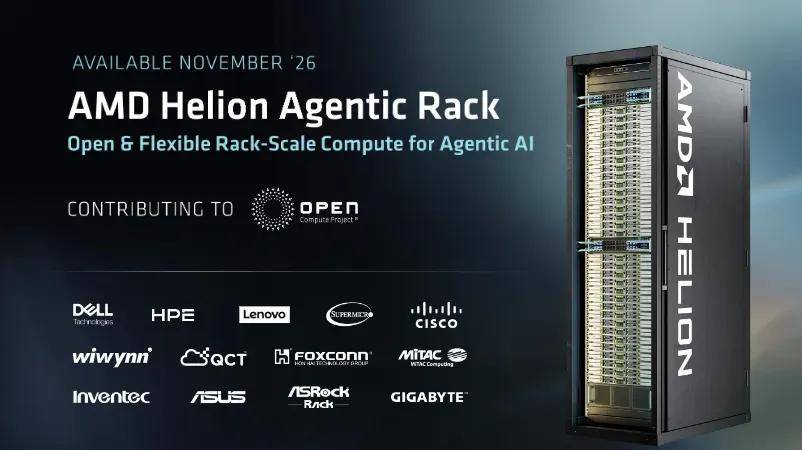
值得一提的是,AMD明确表示将Helion机架架构规范贡献给OCP开源社区,确立其作为公共规范的属性,从而避免行业陷入单一供应商锁定的局限。为了确保这一蓝图能够快速转化为可落地的工业产能,AMD正与全球顶尖系统集成伙伴展开全方位协作,合作伙伴涵盖Cisco、Dell、鸿海、HPE、联想、QCT、Supermicro及Wiwynn等主流OEM/ODM大厂,共同推进标准化机架的商业化制造与部署。基于AMD Helion蓝图的硬件产品与定制化配置,预计将于2026年11月起由全球各大OEM/ODM合作伙伴陆续推出市场并接受订单。
此外,苏姿丰博士还在现场首次公开展示了采用LPDDR内存接口的第六代AMD EPYC数据中心处理器(代号“Verano”),后者计划于2027年正式上市。另根据AMD官方消息,其于去年OCP峰会上首秀的Helios机架产品已开始向客户交付。
2026,AI基础设施发展的关键拐点!
随着全球AI应用快速由传统的单次对话、静态模型推理,跃升至能够自主进行复杂推理、跨系统调用工具以及多步骤任务编排的“智能体AI”时代。
智能体AI与传统预训练大模型推理的最大差异在于其工作负载特性的改变:一个完整的智能体AI请求通常涉及大量的并发任务分发、业务逻辑判断、代码生成运行、向量数据库检索以及多系统API调用。这类“高并发、低时延、强逻辑”的工作流对通用处理器的物理核心数量与体系结构提出了前所未有的要求。底层基础设施对高密度通用算力、异构系统协同与开放式架构的需求呈现出爆发式增长。这意味着在数据中心计算架构经历深刻演进的当下,人工智能基础设施的建设重心正迎来一次根本性的范式转移。
简单来说,过去几年人们谈论AI基础设施,总是围绕着加速卡的单卡算力与集群规模,比如多少GPU、多少HBM等。智能体AI的出现拓宽了工作负载的边界,它需要规划任务、编写/运行代码、调用工具和API、查询数据库或检查工作结果,等等。模型调用只是这个循环中的一个步骤,而围绕它的一切都运行在通用计算之上。AI计算的瓶颈正逐渐向任务编排、上下文管理、数据预处理与多工具调用的吞吐能力转移。
从整个云计算与数据中心行业的发展态势来看,2026年是AI基础设施演进的关键拐点。行业研究与数据表明,AI工作负载正加速从“模型训练”向“大规模推理与智能体协同”转移。
AMD计算与企业AI高级副总裁兼总经理Dan McNamara表示:“智能体AI不是单一的负载类型。它涵盖个人智能体、企业应用、代码执行和复杂工作流,每种场景对计算的需求各不相同。借助AMD Helion,我们将EPYC性能、开源软件和灵活的机架设计结合在一起,使合作伙伴能够围绕客户需求构建系统,并高效利用可用功耗。”
CPU价值的决定性回归与开放阵营的胜利
在传统的AI数据中心中,GPU承担张量计算的核心任务,CPU更多扮演数据搬运和任务调度的辅助角色。但在智能体应用场景中,复杂的工作流编排、API工具调用、代码生成与多任务并发成为真正的瓶颈。而CPU决定了整个系统的调度效率与持续吞吐能力。
TrendForce在2026年6月发布的研究报告中指出,AI应用进入商业化部署阶段,推理与Agentic AI成为主旋律,CPU在AI系统中的调度角色大幅提升,出货量预估显著增长。
这一趋势直接反映在CPU与GPU的配比变化上。AMD在2026年第一季度财报电话会上明确表示,AI基础设施中CPU与GPU的配比正从1∶4至1∶8逐步收敛至1∶1,甚至在智能体密集部署场景下CPU配置数量或反超GPU。AMD Helion蓝图通过在单机架内实现最高32768个CPU核心的突破性设计,重新定义了高性能通用CPU在AI基建中的战略地位。这一设计证明,在智能体时代,强大而密集的CPU算力并非辅助角色,而是决定整个系统编排效率与响应时延的关键基石。
在产品层面,Helios面向AI训练与推理,Helion则聚焦智能体执行。在超大规模部署模型中,Helion CPU机架负责智能体执行,通过102Tbps网络与Helios GPU机架互联,形成“CPU执行+GPU推理”的解耦架构。由此,Helion与Helios天然的互补性,将成为AMD布局AI智能体时代的完美组合。
此外,数据中心面临电力供给紧张、建设成本攀升的双重压力,封闭且昂贵的整机方案正在增加数据中心运营商的资本开支风险。苏姿丰在演讲中强调:“AMD非常重视OCP和开放生态系统……我坚信没有任何一家公司拥有所有问题的答案……当我们作为一个开放生态系统凝聚在一起时,我们就能加快创新步伐,为客户提供更好的解决方案。”这一理念也与当前全球超大规模与企业级数据中心面临的现实困境相契合:单一的封闭架构难以同时兼顾算力效率、能耗控制与成本效益。
在运营层面,针对这一痛点,AMD通过将Helion规范全面贡献给OCP,联合全球顶尖硬件制造商构建起了一个高度互操作的开放生态体系(软件栈基于开源方案,互连则采用UALink和Ultra Ethernet等开放标准)。这种模式赋予了超大规模数据中心客户极大的自由度——客户可以根据自身基础设施的散热条件(液冷或风冷)、供电配额以及具体的应用负载,自由剪裁CPU与加速节点的比例,在保障供应链安全的同时实现最佳的TCO(总体拥有成本)。这一路径与业内过去的垂直整合与垄断策略形成鲜明对比。
写在最后
从训练到推理,从LLM到智能体AI,从GPU单一驱动到CPU+GPU协同驱动,从“单卡浮点”到“整机编排”……AI基础设施也随之经历一场深刻的结构性变革。AMD在OCP 2026上发布的Helion机架,不仅是一款产品,更是一种产业主张——在智能体AI时代,开放标准与通用算力将扮演比以往任何时候都更加关键的角色。苏姿丰博士将2026年定义为“推理之年”,而Helion的推出,正是AMD对这一判断最有力的产品回应。
随着2026年11月商业化落地节点的临近,基于AMD Helion蓝图的智能体AI机架不仅为工业界提供了一份高效、灵活且可拓展的硬件指南,更以坚实的动作践行了开放计算的承诺,为全球Agentic AI的普及奠定了坚实的算力底座。